NVIDIA NIM: Microservicios para Inferencia
NVIDIA NIM ofrece microservicios estandarizados para la inferencia de modelos de IA. Esta lección detalla su propuesta de valor, enfocándose en cómo simplifica el despliegue y escalado de modelos complejos. Abordaremos la unificación de APIs y la optimización del rendimiento en GPUs.
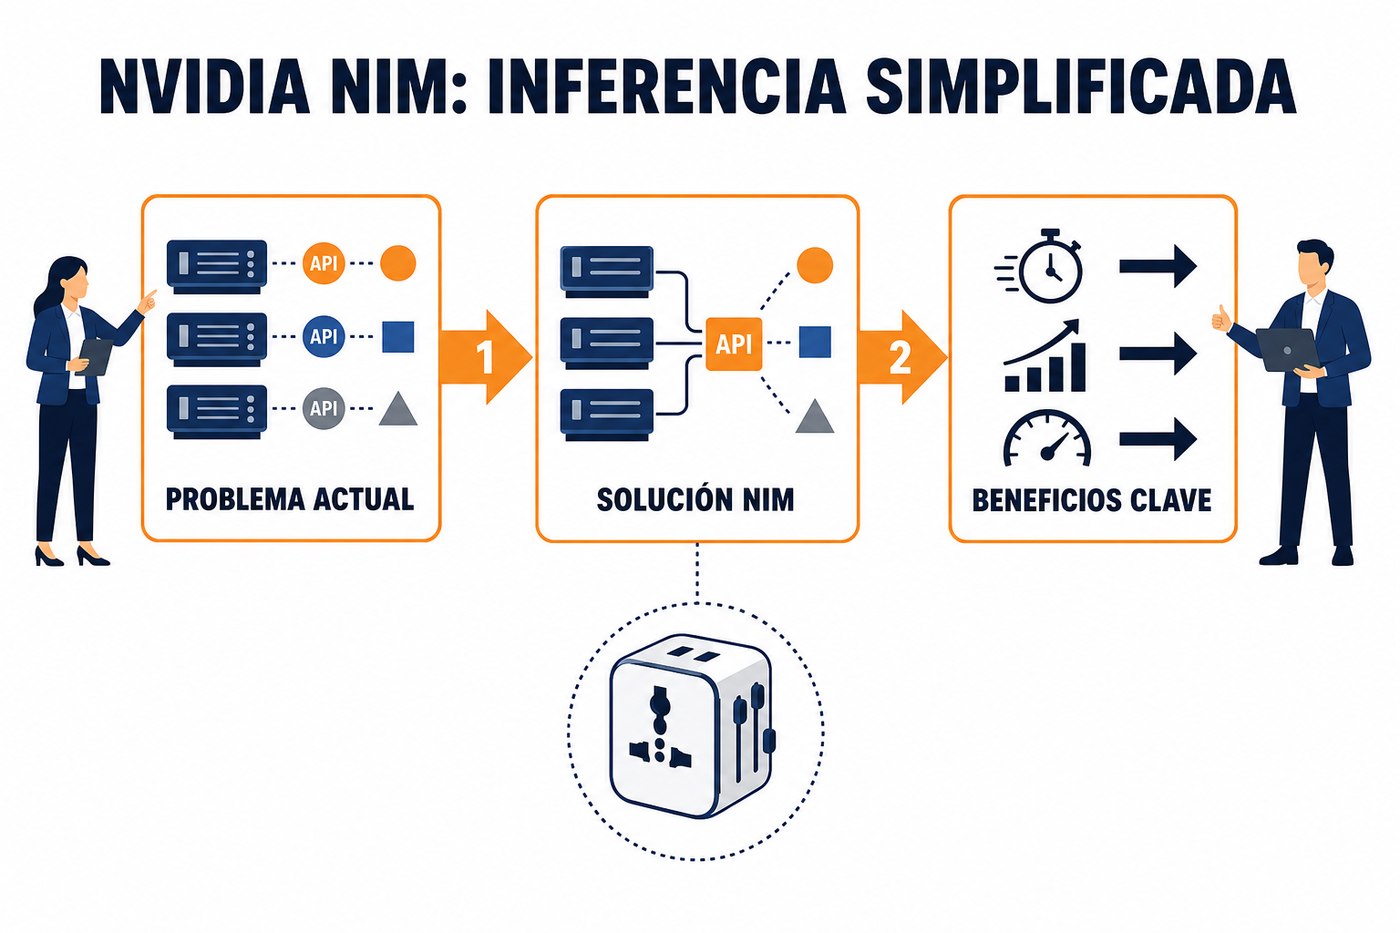
Problema Operativo de la Inferencia Distribuida
La inferencia de modelos de IA a escala presenta desafíos significativos. Cada modelo, framework y hardware puede requerir una configuración de despliegue distinta. Esto conduce a la proliferación de silos tecnológicos, aumentando la complejidad operativa y los costos de mantenimiento. Los equipos de ingeniería dedican tiempo considerable a la integración y optimización de cada modelo para producción, en lugar de enfocarse en el desarrollo de nuevas capacidades. La inconsistencia en las APIs de inferencia entre diferentes modelos y frameworks es un punto crítico, dificultando la integración con aplicaciones de consumo.
Propuesta de Valor de NVIDIA NIM
NVIDIA NIM (NVIDIA Inference Microservices) aborda estos problemas al ofrecer un conjunto de microservicios pre-construidos y optimizados para la inferencia de modelos de IA. Su objetivo principal es estandarizar el proceso de despliegue y consumo de modelos, independientemente de su origen o framework. Esto se logra mediante una capa de abstracción que encapsula la complejidad subyacente de la optimización del modelo y la interacción con el hardware GPU.
- Estandarización de APIs: Proporciona APIs unificadas (REST y gRPC) para la inferencia, eliminando la necesidad de adaptar el código de la aplicación a cada modelo específico.
- Optimización de Rendimiento: Los microservicios NIM están pre-optimizados para GPUs NVIDIA, utilizando técnicas como TensorRT, Triton Inference Server y CuDNN para maximizar el throughput y minimizar la latencia.
- Contenerización: Cada microservicio se empaqueta como un contenedor Docker, facilitando su despliegue en cualquier entorno compatible con contenedores (on-premise, nube, edge).
- Soporte Multi-Framework: Compatible con modelos entrenados en frameworks populares como PyTorch, TensorFlow, JAX, y ONNX, entre otros.
- Gestión de Modelos: Simplifica la carga, descarga y actualización de modelos sin interrupción del servicio.
Unificación de APIs y Experiencia de Desarrollo
Uno de los pilares de NIM es la unificación de la interfaz de inferencia. En lugar de interactuar con APIs específicas de cada framework (por ejemplo, TensorFlow Serving, PyTorch Serve), los desarrolladores interactúan con una API REST o gRPC consistente proporcionada por NIM. Esto reduce la curva de aprendizaje y acelera el desarrollo de aplicaciones que consumen múltiples modelos de IA. La abstracción permite que los equipos se centren en la lógica de negocio de la aplicación, en lugar de en los detalles de la integración de la inferencia.
Evalúe el costo de oportunidad de desarrollar y mantener APIs de inferencia personalizadas frente a adoptar una solución estandarizada como NIM. Considere el tiempo de ingeniería liberado y la reducción de deuda técnica a largo plazo.
Componentes Clave y Flujo de Trabajo
Los microservicios NIM se construyen sobre componentes probados de NVIDIA AI Enterprise. El flujo de trabajo típico implica:
- Entrenamiento del Modelo: El modelo se entrena utilizando el framework de preferencia (PyTorch, TensorFlow, etc.).
- Optimización (Opcional pero Recomendada): El modelo puede ser optimizado con herramientas como NVIDIA TensorRT para mejorar el rendimiento en GPUs.
- Empaquetado del Modelo: El modelo optimizado se prepara para ser servido por Triton Inference Server, que es el motor subyacente de los microservicios NIM.
- Despliegue del Microservicio NIM: Se despliega el contenedor Docker del microservicio NIM correspondiente, que incluye Triton Inference Server pre-configurado para el modelo.
- Inferencia: Las aplicaciones cliente envían solicitudes de inferencia a la API estándar del microservicio NIM.
Este enfoque modular permite a los equipos desacoplar el ciclo de vida del desarrollo del modelo del ciclo de vida del despliegue, mejorando la agilidad y la capacidad de respuesta a los cambios.
Aplicación Práctica: Evaluación Interna de NIM
Para el lunes, identifique un proyecto interno en INT que actualmente utilice inferencia de modelos de IA y que presente desafíos de despliegue, escalabilidad o mantenimiento de APIs. Prepare una breve justificación de por qué este proyecto podría beneficiarse de la adopción de NVIDIA NIM. Considere los siguientes puntos:
- ¿Cuántos modelos diferentes se están sirviendo en producción?
- ¿Qué frameworks de IA se utilizan para estos modelos?
- ¿Existe un esfuerzo significativo para mantener las APIs de inferencia o para integrar nuevos modelos?
- ¿Se han identificado cuellos de botella de rendimiento en la inferencia actual?
El objetivo es iniciar una discusión técnica sobre la viabilidad de NIM para estandarizar y optimizar nuestros procesos de inferencia interna, sentando las bases para una posible prueba de concepto.
There are no comments for now.
to be the first to leave a comment.