Arquitectura de Contenedores NIM
NVIDIA NIM empaqueta modelos de IA como microservicios en contenedores. Esta arquitectura estandariza el despliegue de inferencia, facilitando la portabilidad y escalabilidad. Entender cómo funcionan estos contenedores es clave para una operación eficiente y consistente en cualquier entorno.
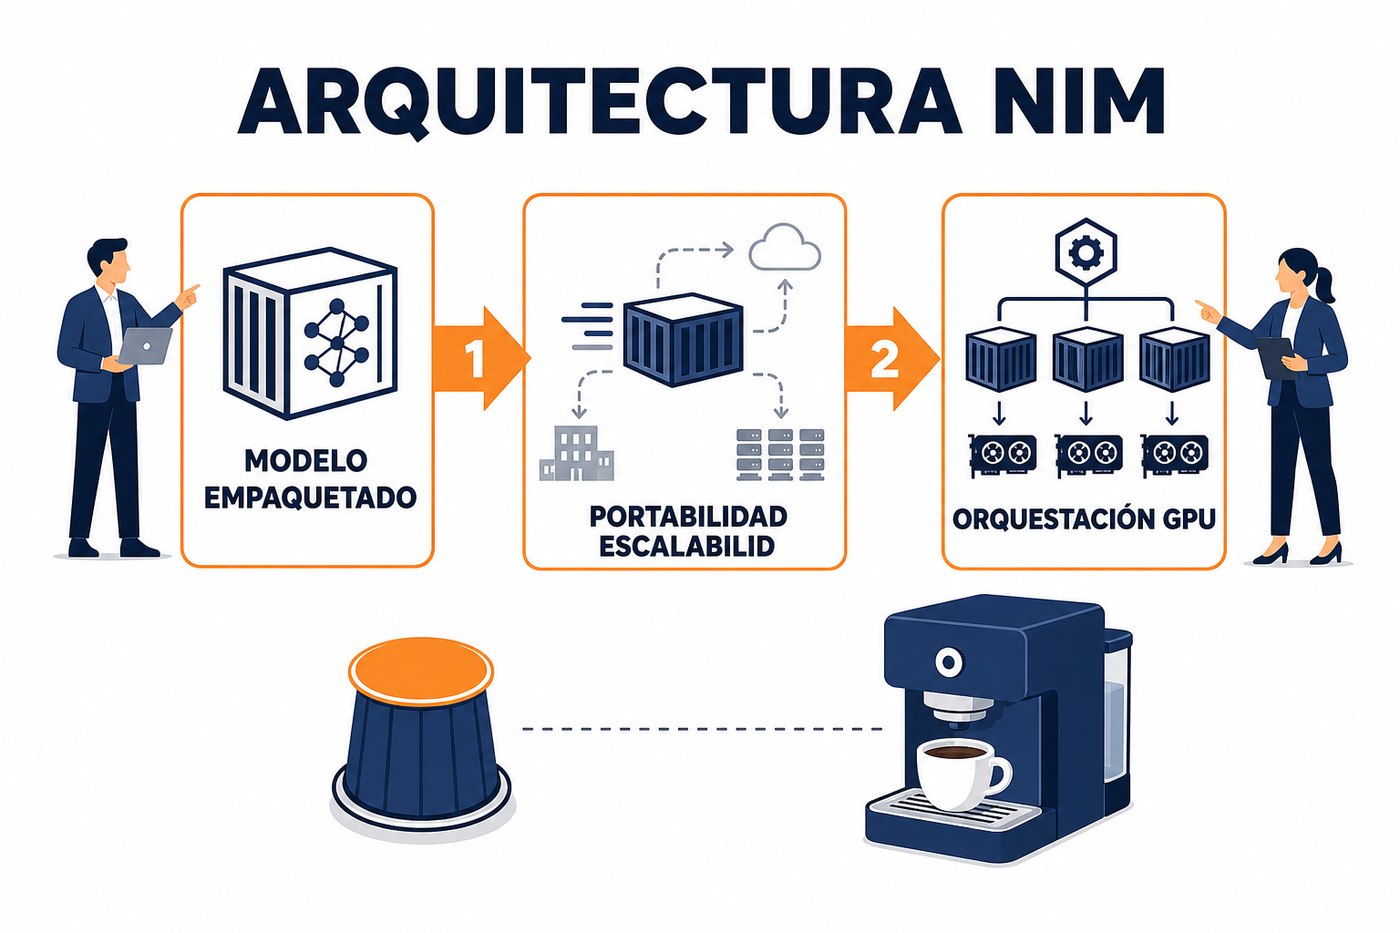
Contenedores: Empaquetamiento Estándar para Inferencia
Los microservicios de inferencia de NVIDIA NIM se distribuyen como imágenes de contenedor. Una imagen de contenedor es un paquete ejecutable ligero, autónomo e independiente que incluye todo lo necesario para ejecutar una pieza de software: el código, un tiempo de ejecución, bibliotecas del sistema, herramientas del sistema y configuraciones. En el contexto de NIM, esto significa que cada microservicio de inferencia para un modelo específico (ej. un modelo de lenguaje grande, un modelo de visión) viene preconfigurado dentro de su propio contenedor.
La ventaja principal de este enfoque es la consistencia ambiental. Un contenedor se ejecuta de la misma manera en cualquier sistema que tenga un motor de contenedores compatible (como Docker o Podman), independientemente del sistema operativo subyacente o las bibliotecas instaladas. Esto elimina problemas comunes de "funciona en mi máquina" y simplifica la migración entre entornos de desarrollo, prueba y producción.
Componentes de un Contenedor NIM
Cada contenedor NIM encapsula la lógica de inferencia para un modelo específico. Sus componentes clave incluyen:
- Modelo de IA preentrenado: El archivo del modelo (ej. .pt, .onnx, .safetensors) optimizado para inferencia.
- NVIDIA Triton Inference Server: El motor de inferencia de alto rendimiento que sirve el modelo. Triton gestiona la carga del modelo, la ejecución de inferencia en GPU y la exposición de las API.
- Dependencias del modelo: Todas las bibliotecas y paquetes necesarios para que el modelo y Triton funcionen correctamente (ej. PyTorch, TensorFlow, CUDA, cuDNN).
- Configuración: Archivos de configuración para Triton y el modelo, especificando parámetros como el tipo de modelo, la ruta, los puertos de escucha y las opciones de optimización.
- API estándar: Los contenedores NIM exponen una API RESTful y gRPC consistente, facilitando la integración con aplicaciones cliente.
Los contenedores NIM están diseñados para ser inmutables. Una vez construida la imagen, no se modifica en tiempo de ejecución. Cualquier cambio en el modelo o su configuración requiere construir una nueva imagen de contenedor. Esto asegura la trazabilidad y la reproducibilidad de los despliegues.
Portabilidad y Escalabilidad con Contenedores
La arquitectura de contenedores es fundamental para la portabilidad y escalabilidad de los microservicios NIM:
- Portabilidad: Los contenedores pueden ejecutarse en cualquier entorno que soporte un motor de contenedores y tenga acceso a GPU NVIDIA. Esto incluye desde una estación de trabajo de desarrollo hasta clústeres de servidores on-premise o servicios de nube pública (AWS, Azure, GCP). La misma imagen de contenedor se puede usar en todos estos entornos, reduciendo la fricción en el ciclo de vida de desarrollo y despliegue.
- Escalabilidad: Los contenedores son unidades de despliegue ligeras. Esto permite escalar horizontalmente los microservicios de inferencia de manera eficiente. Si la demanda de inferencia aumenta, se pueden iniciar múltiples instancias del mismo contenedor en diferentes GPU o nodos. Orquestadores de contenedores como Kubernetes gestionan automáticamente la creación, eliminación y balanceo de carga de estas instancias, asegurando que la capacidad de inferencia se ajuste a la demanda.
Orquestación de Contenedores y GPU
Para desplegar y gestionar contenedores NIM a escala, se utilizan orquestadores de contenedores. Kubernetes es el estándar de facto en este ámbito. Kubernetes permite:
- Despliegue automatizado: Definir cómo y dónde se ejecutan los contenedores.
- Autoescalado: Ajustar el número de instancias de contenedores según la carga.
- Balanceo de carga: Distribuir el tráfico de inferencia entre las instancias disponibles.
- Recuperación automática: Reiniciar contenedores fallidos o moverlos a nodos saludables.
- Gestión de recursos: Asignar recursos de CPU, memoria y, crucialmente, GPU a los contenedores.
NVIDIA proporciona el NVIDIA GPU Operator para Kubernetes, que facilita la gestión y asignación de GPU a los contenedores. Este operador detecta y configura automáticamente las GPU en los nodos del clúster, permitiendo que Kubernetes las vea como un recurso programable y las asigne a los pods (grupos de contenedores) que ejecutan los microservicios NIM.
apiVersion: v1
kind: Pod
metadata:
  name: nim-llm-pod
spec:
  containers:
    - name: llm-inference
      image: nvcr.io/nvidia/nim/llm-model-a:latest
      resources:
        limits:
          nvidia.com/gpu: 1 # Solicita una GPU
      env:
        - name: TRITON_HTTP_PORT
          value: "8000"
  restartPolicy: Always
El fragmento YAML anterior ilustra cómo un Pod de Kubernetes solicita una GPU específica para un contenedor que ejecuta un microservicio NIM. La línea nvidia.com/gpu: 1 es la clave para la asignación de recursos de GPU.
Aplicación Práctica: Preparación para el Despliegue Consistente
Al entender la arquitectura de contenedores de NIM, el equipo puede tomar decisiones informadas para un despliegue y operación eficientes. Para la próxima semana, considere lo siguiente:
- Familiarícese con Docker: Si no está familiarizado con los conceptos básicos de Docker (imágenes, contenedores, volúmenes, redes), dedique tiempo a entenderlos. Es la base para trabajar con NIM.
- Investigue Kubernetes: Explore los fundamentos de Kubernetes, especialmente cómo gestiona los recursos y cómo se despliegan las aplicaciones. Preste atención a los conceptos de Pods, Deployments y Services.
- Evalúe la infraestructura existente: Determine si su infraestructura actual (on-premise o en la nube) tiene la capacidad para ejecutar motores de contenedores y, si aplica, Kubernetes. Verifique la compatibilidad con el NVIDIA GPU Operator para la gestión de GPU.
There are no comments for now.
to be the first to leave a comment.