Configuración de Contenedores NIM y Modelos
Esta lección detalla la configuración de contenedores NVIDIA NIM para la inferencia de modelos. Cubriremos la carga de modelos preentrenados, la configuración de contenedores y los pasos para asegurar su operación óptima, enfocándonos en la preparación para el servicio.
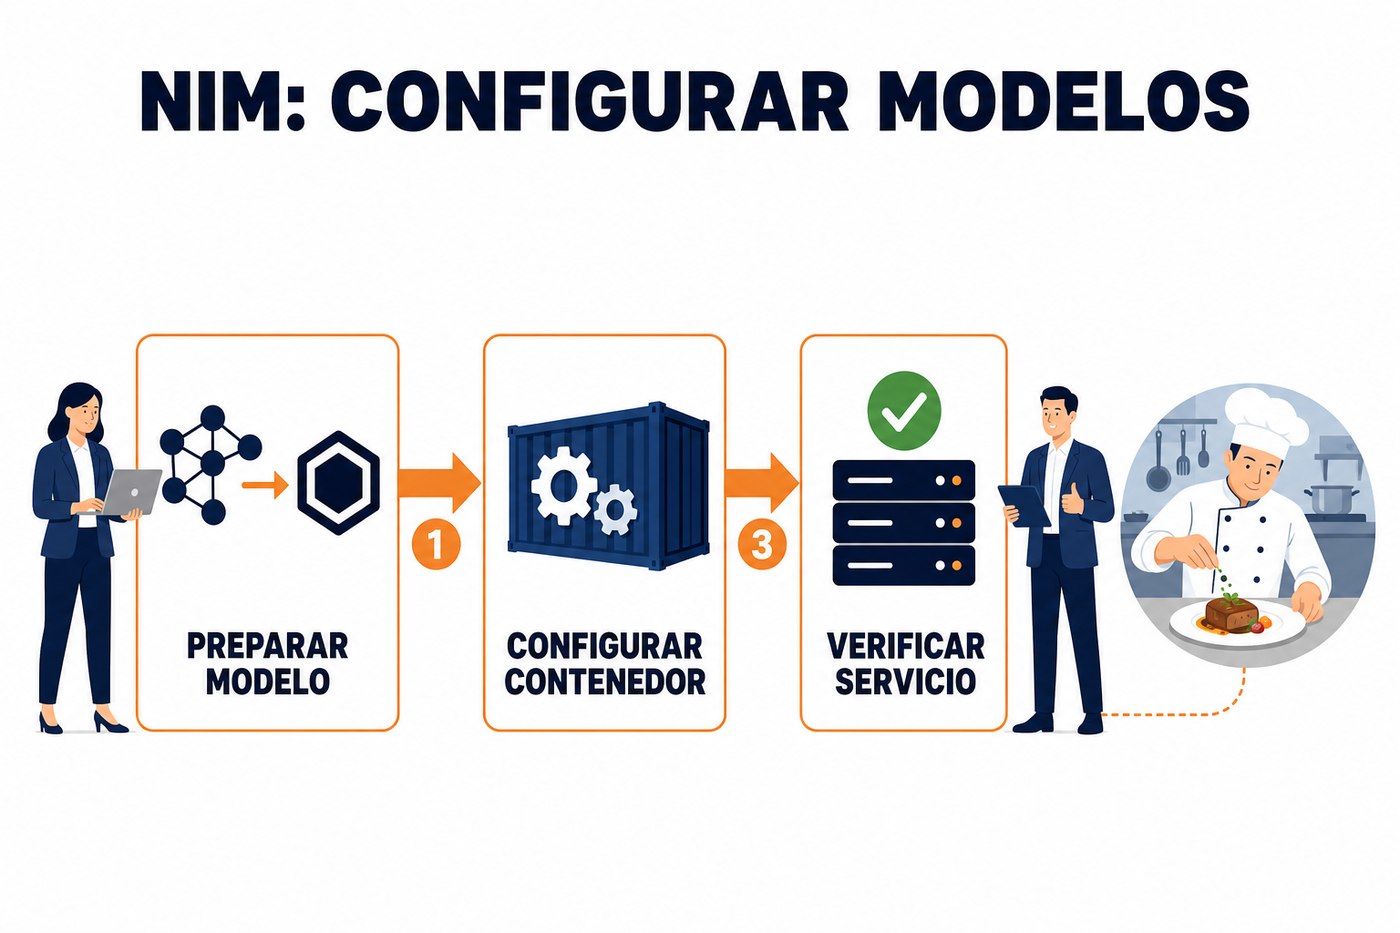
Principios del Despliegue de Modelos en NIM
NVIDIA NIM simplifica el despliegue de modelos de IA mediante microservicios en contenedores. Cada microservicio NIM encapsula un modelo específico, junto con todas sus dependencias, permitiendo una ejecución aislada y escalable. El objetivo es proporcionar una API estandarizada para la inferencia, independientemente del modelo subyacente o del framework de IA utilizado.
La clave del despliegue en NIM es la portabilidad. Al estar en un contenedor, un modelo NIM puede ejecutarse consistentemente en diversas infraestructuras, ya sean GPUs locales, centros de datos o entornos de nube. Esto reduce la fricción en la migración y la gestión de versiones.
Preparación del Modelo para NIM
Antes de cargar un modelo en un contenedor NIM, es necesario asegurar que esté en un formato compatible y optimizado para la inferencia. NVIDIA NIM soporta varios formatos, pero la recomendación es utilizar ONNX (Open Neural Network Exchange) o TensorRT, este último para la máxima optimización en GPUs NVIDIA.
- Conversión a ONNX: Muchos modelos entrenados en frameworks como PyTorch o TensorFlow pueden exportarse a ONNX. Esto se hace típicamente con funciones de exportación dentro del propio framework. Por ejemplo, en PyTorch, se usa
torch.onnx.export(). - Optimización con TensorRT: Para modelos que requieren la máxima eficiencia en inferencia, TensorRT es la herramienta de NVIDIA para optimizar grafos de red neuronal. Reduce la latencia y aumenta el throughput mediante la fusión de capas, la cuantificación de precisión y la selección de kernels optimizados para la GPU. TensorRT puede importar modelos ONNX o directamente desde algunos frameworks.
Si el modelo es de baja latencia crítica o el volumen de inferencia es muy alto, la optimización con TensorRT es obligatoria. Para pruebas iniciales o modelos con requisitos de rendimiento menos estrictos, ONNX puede ser suficiente.
Carga y Configuración del Contenedor NIM
Los contenedores NIM se obtienen del NVIDIA NGC Catalog. Cada microservicio NIM está diseñado para un tipo de modelo o tarea específica (e.g., LLM, visión por computadora). Una vez que el modelo está preparado, se monta dentro del contenedor NIM.
- Descarga de la Imagen NIM: Utilice Docker o Podman para descargar la imagen del microservicio NIM deseado desde NGC. Por ejemplo, para un microservicio de LLM:
- Preparación del Directorio del Modelo: Cree una estructura de directorios que contenga su modelo optimizado. La estructura exacta puede variar ligeramente según el microservicio NIM, pero generalmente incluye el archivo del modelo y un archivo de configuración (e.g.,
config.pbtxtpara Triton Inference Server, que es la base de muchos NIMs). - Ejecución del Contenedor: Lance el contenedor NIM, montando el directorio de su modelo como un volumen. Esto permite que el microservicio acceda a su modelo. Es crucial asignar los recursos de GPU correctamente.
- Configuración Específica del Modelo: Algunos microservicios NIM permiten configurar parámetros específicos del modelo a través de variables de entorno o archivos de configuración dentro del directorio montado. Esto puede incluir el tamaño de batch, la precisión (FP16/FP32), o parámetros de tokenización para LLMs.
docker pull nvcr.io/nvidia/nim/llm/llama3-8b-instruct:1.0.0

docker run --runtime=nvidia --rm -it -p 8000:8000 \
 -v /ruta/a/tu/modelo:/models \
 nvcr.io/nvidia/nim/llm/llama3-8b-instruct:1.0.0
En el ejemplo anterior, /ruta/a/tu/modelo debe ser la ruta local donde se encuentra su modelo optimizado y su configuración. El contenedor NIM esperará encontrar el modelo en el directorio /models.
Verificación y Prueba del Servicio
Una vez que el contenedor NIM está en ejecución, es fundamental verificar que el modelo se haya cargado correctamente y que el servicio de inferencia esté operativo. La mayoría de los microservicios NIM exponen un endpoint de salud y un endpoint de inferencia compatible con la API de NVIDIA Triton Inference Server.
- Endpoint de Salud: Acceda al endpoint
/v2/health/ready(o similar) para confirmar que el servidor está listo para recibir solicitudes. - Prueba de Inferencias: Envíe una solicitud de inferencia de prueba al endpoint del modelo (e.g.,
/v2/models/your_model_name/infer) con datos de entrada válidos. Esto confirmará que el modelo está procesando las solicitudes correctamente.
curl -v localhost:8000/v2/health/readySi el servicio no responde o el modelo no carga, revise los logs del contenedor Docker para identificar errores. Los problemas comunes incluyen rutas de modelo incorrectas, formatos de modelo incompatibles o falta de recursos de GPU.
Aplicación Práctica: Despliegue de un Modelo de Visión
Para el lunes, identifique un modelo de visión por computadora preentrenado (e.g., ResNet50, YOLOv5) que su equipo ya utilice o tenga disponible. El objetivo es prepararlo para un despliegue en NIM.
- Paso 1: Convertir a ONNX. Si su modelo no está ya en ONNX, utilice las herramientas de su framework para exportarlo. Verifique la exportación ejecutando una inferencia básica con ONNX Runtime.
- Paso 2: Investigar el Microservicio NIM. Busque en el NVIDIA NGC Catalog un microservicio NIM adecuado para inferencia de visión. Anote el nombre de la imagen Docker y los requisitos de montaje de modelos.
- Paso 3: Estructura del Directorio. Cree una carpeta local con la estructura esperada por el microservicio NIM y coloque su modelo ONNX dentro. Si se requiere un archivo de configuración (e.g.,
config.pbtxt), cree uno básico con los parámetros del modelo. - Paso 4: Planificar el Comando Docker. Prepare el comando
docker runcon los volúmenes y puertos necesarios, listo para ejecutar el contenedor NIM con su modelo montado. No es necesario ejecutarlo aún, solo tener el comando listo para la siguiente lección.
There are no comments for now.
to be the first to leave a comment.