Estrategias de Despliegue: On-Premise con NIM
El despliegue de NVIDIA NIM en infraestructura local (on-premise) ofrece control total sobre los recursos y los datos. Esta lección detalla los factores críticos para una implementación exitosa, abarcando desde la selección del hardware hasta las consideraciones de red y seguridad, permitiendo evaluar la viabilidad de esta estrategia.
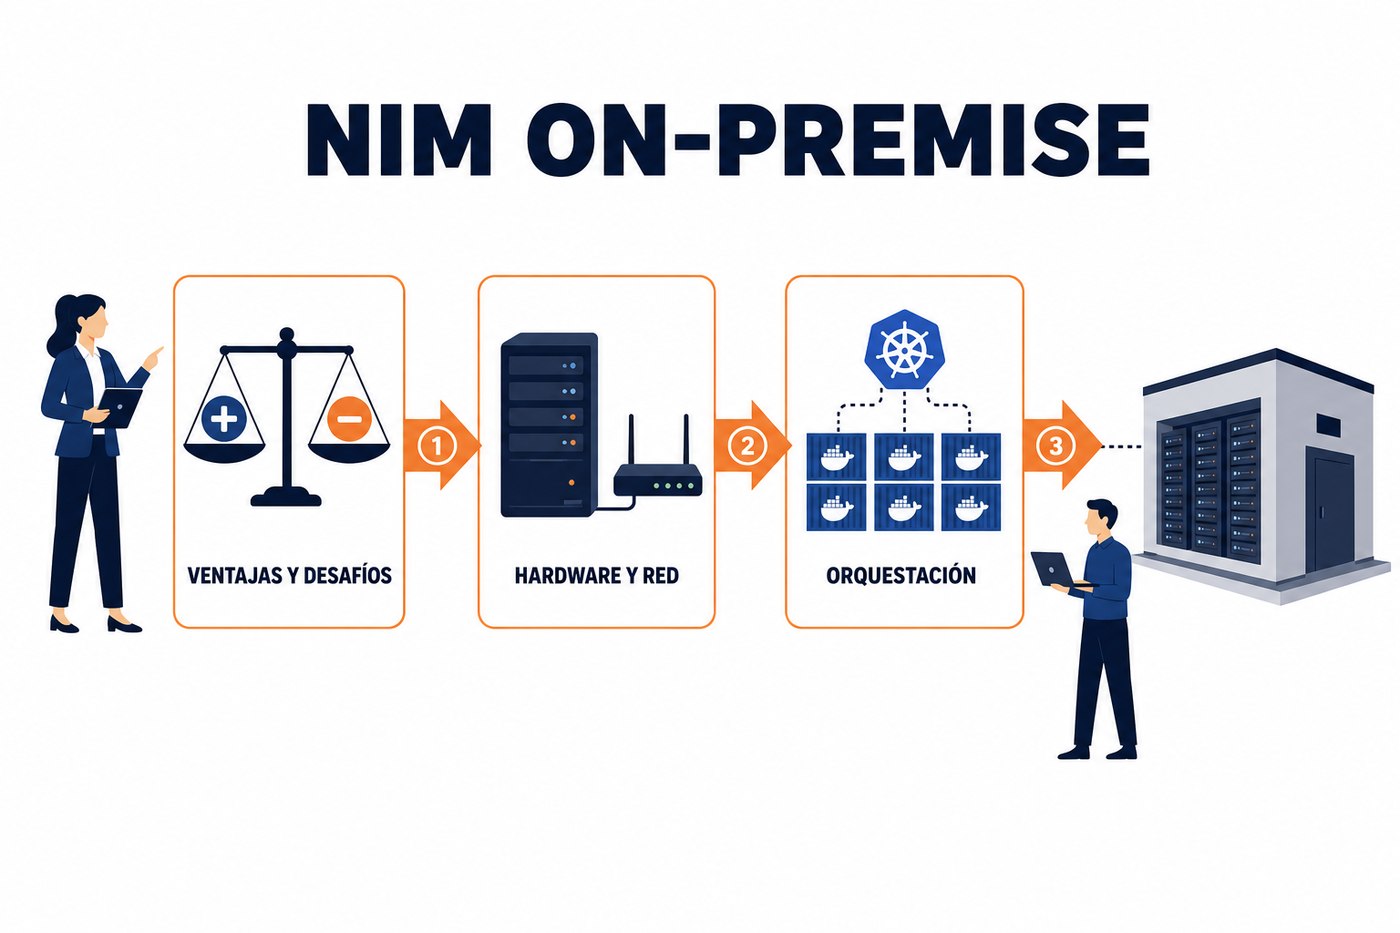
Ventajas y Desafíos del Despliegue On-Premise
El despliegue on-premise de microservicios NIM es la opción preferida cuando la soberanía de datos, la latencia mínima o el control estricto sobre la infraestructura son requisitos no negociables. Permite optimizar el hardware para cargas de trabajo específicas de inferencia y mantener los datos sensibles dentro del perímetro de seguridad de la organización. Sin embargo, esta estrategia implica una inversión inicial significativa en hardware y la necesidad de personal con experiencia en la gestión de infraestructura de GPU y contenedores.
Las principales ventajas incluyen:
- Control de datos: Los datos de inferencia nunca salen del entorno local, cumpliendo con normativas estrictas de privacidad y seguridad.
- Latencia predecible: Al eliminar la dependencia de redes externas, se logra una latencia de inferencia más consistente y baja, crítica para aplicaciones en tiempo real.
- Optimización de costos a largo plazo: Tras la inversión inicial, los costos operativos pueden ser menores que los de la nube para cargas de trabajo estables y de alto volumen.
- Personalización: Posibilidad de configurar el hardware y el software de manera precisa para las necesidades específicas del modelo y la aplicación.
Los desafíos asociados son:
- Inversión inicial: Adquisición de servidores con GPU, almacenamiento y equipos de red.
- Gestión de infraestructura: Responsabilidad total sobre el mantenimiento, actualizaciones y resolución de problemas de hardware y software.
- Escalabilidad: La expansión de capacidad requiere la compra e instalación de nuevo hardware, lo que puede ser lento en comparación con la escalabilidad elástica de la nube.
- Consumo energético y enfriamiento: Las GPU de alto rendimiento demandan infraestructura de energía y sistemas de enfriamiento robustos.
Selección de Hardware para NIM On-Premise
La elección del hardware es fundamental para el rendimiento de NIM. Se requieren GPU NVIDIA empresariales (ej. NVIDIA H100, A100, L40S) con suficiente memoria para cargar el modelo y ejecutar la inferencia. La cantidad de memoria de GPU necesaria depende del tamaño del modelo, el tamaño del lote (batch size) y la precisión de los datos (FP32, FP16, INT8).
Además de las GPU, se debe considerar:
- CPU: Procesadores modernos con un número adecuado de núcleos para gestionar las operaciones del sistema operativo, el orquestador de contenedores (ej. Kubernetes) y las solicitudes de inferencia. Aunque la inferencia es intensiva en GPU, una CPU débil puede convertirse en un cuello de botella.
- Memoria RAM: Suficiente RAM para el sistema operativo, los contenedores y cualquier proceso auxiliar. Una regla general es tener al menos 2-4 veces la memoria RAM de la CPU por cada GPU, aunque esto varía según la carga de trabajo.
- Almacenamiento: SSD NVMe de alta velocidad para el sistema operativo, las imágenes de contenedores y los modelos. El acceso rápido al almacenamiento es crucial durante el arranque y la carga de modelos.
- Interconexión de red: Tarjetas de red de alta velocidad (10 GbE o superior) son esenciales para manejar el tráfico de solicitudes de inferencia y la transferencia de datos entre servidores, especialmente en configuraciones de múltiples nodos o clústeres.
Siempre sobredimensione ligeramente la memoria RAM y el almacenamiento, ya que el costo marginal es bajo en comparación con el impacto de un cuello de botella. Para GPU, valide el requisito de memoria con el proveedor del modelo o mediante pruebas de carga previas.
Consideraciones de Red y Seguridad
El rendimiento y la seguridad del despliegue NIM on-premise dependen en gran medida de una infraestructura de red bien diseñada y de políticas de seguridad robustas.
- Red interna: Utilice una red de baja latencia y alto ancho de banda para la comunicación entre los nodos del clúster (si aplica) y entre los clientes que consumen los microservicios NIM y los servidores de inferencia. Esto minimiza el impacto del transporte de datos en la latencia total de inferencia. Considere VLANs dedicadas para el tráfico de inferencia.
- Balanceo de carga: Implemente balanceadores de carga (ej. NGINX, HAProxy, o soluciones de Kubernetes Ingress) para distribuir las solicitudes de inferencia entre múltiples instancias de NIM, garantizando alta disponibilidad y escalabilidad horizontal.
- Firewalls: Configure firewalls para restringir el acceso a los puertos de los microservicios NIM solo a las aplicaciones y usuarios autorizados. Siga el principio de privilegio mínimo.
- Autenticación y Autorización: Integre los microservicios NIM con sistemas de autenticación y autorización existentes (ej. LDAP, OAuth2/OIDC) para controlar quién puede invocar los modelos y con qué permisos. NVIDIA NIM soporta integración con estas soluciones.
- Cifrado: Asegure que toda la comunicación entre clientes y los microservicios NIM se realice a través de canales cifrados (HTTPS/TLS).
- Monitoreo de red: Implemente herramientas de monitoreo de red para detectar anomalías, cuellos de botella y posibles ataques de seguridad. Esto es crítico para mantener el rendimiento y la integridad del servicio.
Orquestación y Gestión de Contenedores
NVIDIA NIM se distribuye como contenedores Docker, lo que hace que Kubernetes sea el orquestador ideal para su despliegue on-premise. Kubernetes permite gestionar el ciclo de vida de los contenedores, escalar dinámicamente, asegurar la alta disponibilidad y automatizar el despliegue.
- NVIDIA Container Toolkit: Es un requisito previo para ejecutar contenedores con soporte de GPU en Docker y Kubernetes. Permite que los contenedores accedan directamente a las GPU y a los drivers de NVIDIA.
- Kubernetes Device Plugins: Para que Kubernetes pueda programar cargas de trabajo en GPU, se deben instalar los Device Plugins de NVIDIA. Estos plugins anuncian las GPU disponibles en los nodos y permiten a los pods solicitar recursos de GPU específicos.
- Helm Charts: NVIDIA proporciona Helm Charts o ejemplos de manifiestos de Kubernetes para facilitar el despliegue de los microservicios NIM, simplificando la configuración y gestión.
- Almacenamiento persistente: Si los microservicios NIM requieren almacenar modelos o datos de configuración que persistan entre reinicios, configure volúmenes persistentes en Kubernetes, utilizando soluciones como NFS, Ceph o almacenamiento definido por software.
apiVersion: v1
kind: Pod
metadata:
  name: nim-inference-pod
spec:
  containers:
    - name: nim-model-server
      image: nvcr.io/nvidia/nim/llm/llama3-8b-instruct:1.0.0
      resources:
        limits:
          nvidia.com/gpu: 1 # Solicita una GPU
      env:
        - name: NVIDIA_VISIBLE_DEVICES
          value: all
        - name: TRITON_SERVER_ARGS
          value: "--model-repository=/models --log-verbose=1"
      volumeMounts:
        - name: model-volume
          mountPath: /models
  volumes:
    - name: model-volume
      hostPath:
        path: /path/to/your/models # Ruta donde están los modelos en el host
        type: Directory
Monitoreo y Operación
El monitoreo continuo es indispensable para mantener la estabilidad y el rendimiento de los despliegues NIM on-premise. Se deben monitorear tanto el hardware subyacente como los microservicios NIM en sí.
- Métricas de GPU: Utilice herramientas como `nvidia-smi` o Prometheus con el exporter de NVIDIA DCGM (Data Center GPU Manager) para monitorear el uso de GPU, la temperatura, el consumo de memoria y la utilización de los núcleos de cómputo.
- Métricas de contenedores: Monitoree el uso de CPU, RAM y red de los contenedores NIM a través de cAdvisor o herramientas de monitoreo de Kubernetes (ej. Prometheus y Grafana).
- Métricas de NIM: Los microservicios NIM exponen métricas de rendimiento (latencia, throughput, errores) que pueden ser recolectadas para evaluar la salud del servicio y la eficiencia de la inferencia.
- Logs: Centralice los logs de los contenedores NIM y del sistema operativo para facilitar la depuración y el análisis de problemas.
Aplicación Práctica: Checklist de Despliegue On-Premise
Para el lunes, al considerar un despliegue NIM on-premise, siga este checklist inicial:
- Defina los requisitos de inferencia: ¿Qué modelos se desplegarán? ¿Cuál es su tamaño? ¿Cuál es la latencia y el throughput objetivo? ¿Qué volumen de solicitudes se espera?
- Evalúe el hardware existente: ¿Hay GPU NVIDIA empresariales disponibles? ¿Son compatibles con los requisitos de los modelos? ¿La CPU, RAM y almacenamiento son adecuados? Si no, cotice el hardware necesario.
- Planifique la red: Identifique los requisitos de ancho de banda y latencia. Defina la estrategia de balanceo de carga y los puertos a abrir en los firewalls.
- Diseñe la seguridad: Establezca la política de acceso, autenticación y autorización para los microservicios NIM. Asegure el cifrado de las comunicaciones.
- Prepare el entorno de orquestación: Asegúrese de que Kubernetes esté instalado y configurado con el NVIDIA Container Toolkit y los Device Plugins. Tenga listos los Helm Charts o manifiestos para los microservicios NIM.
- Establezca el monitoreo: Defina las herramientas y métricas clave a monitorear para GPU, contenedores y los propios microservicios NIM. Configure alertas para umbrales críticos.
There are no comments for now.
to be the first to leave a comment.