Monitoreo continuo y alertas en producción
El monitoreo continuo es crítico para la operación estable y eficiente de agentes LangGraph en producción. Permite identificar desviaciones de comportamiento, degradación del rendimiento o fallos antes de que escalen. Esta lección cubre cómo configurar sistemas de monitoreo y alertas para mantener la confiabilidad y disponibilidad de sus agentes.
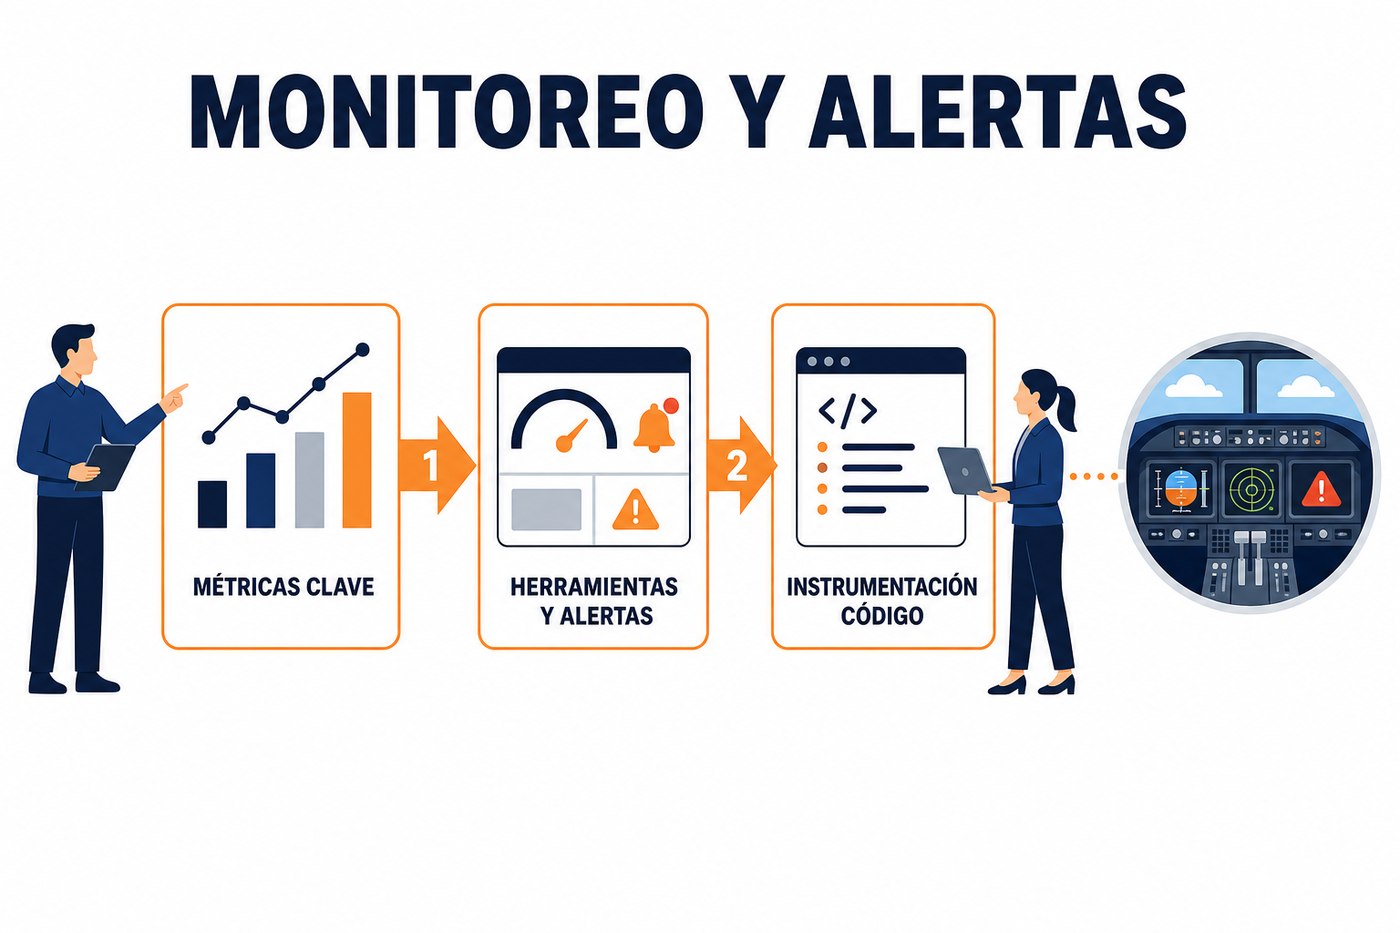
Métricas clave para agentes LangGraph
Para monitorear eficazmente, es fundamental recolectar métricas relevantes que reflejen el estado operativo del agente. Estas métricas se dividen en categorías:
- Métricas de rendimiento: Latencia promedio por ejecución, latencia máxima, tasa de errores (ejecuciones fallidas / total de ejecuciones), rendimiento (ejecuciones por segundo o minuto). Estas indican la eficiencia y fiabilidad del procesamiento.
- Métricas de uso de recursos: Consumo de CPU, memoria, I/O de disco y red del contenedor o instancia donde se ejecuta el agente. Es vital para detectar cuellos de botella o fugas de memoria.
- Métricas específicas de LangGraph: Número de pasos en una trayectoria promedio, tiempo de ejecución por nodo, uso de tokens (input/output) por ejecución, costo por ejecución (si se integra con APIs de LLM de pago), tasa de reintentos.
- Métricas de negocio: Si el agente tiene un objetivo de negocio claro (ej. resolver tickets, generar reportes), métricas como la tasa de resolución exitosa o la calidad de la salida (evaluada automáticamente o por feedback) son cruciales. Estas requieren instrumentación adicional.
La instrumentación de estas métricas se realiza a través de bibliotecas de monitoreo estándar (ej. Prometheus client libraries, OpenTelemetry) integradas en el código del agente o mediante la recolección automática del entorno de despliegue (ej. métricas de Kubernetes, Cloud Monitoring).
Herramientas de monitoreo y observabilidad
La elección de la herramienta depende del ecosistema de infraestructura y las necesidades específicas. Las soluciones comunes incluyen:
- Prometheus + Grafana: Prometheus recolecta y almacena métricas de series de tiempo. Grafana se usa para visualizar estas métricas en dashboards personalizables. Es una combinación potente y de código abierto, ampliamente usada en entornos de Kubernetes.
- Cloud Monitoring (Google Cloud), CloudWatch (AWS), Azure Monitor (Azure): Soluciones nativas de la nube que ofrecen recolección de métricas, logs y trazas, con capacidades integradas de dashboarding y alertas. Se integran bien con otros servicios de la misma nube.
- Datadog, New Relic, Dynatrace: Plataformas de observabilidad comerciales que ofrecen una suite completa de monitoreo de infraestructura, aplicaciones, logs y experiencias de usuario. Proporcionan agentes robustos para la recolección de datos y dashboards avanzados.
Priorice la integración con las herramientas de monitoreo existentes en la organización. Introducir una nueva herramienta solo para LangGraph puede aumentar la complejidad operativa y la curva de aprendizaje del equipo de SRE.
Configuración de alertas
Las alertas transforman las métricas en notificaciones accionables. Una alerta bien configurada debe ser oportuna, clara y dirigida al equipo correcto. Considere los siguientes tipos de alertas:
- Umbrales estáticos: Se dispara una alerta cuando una métrica supera o cae por debajo de un valor predefinido (ej. latencia > 5 segundos, tasa de errores > 1%).
- Umbrales dinámicos/basados en anomalías: Utilizan algoritmos para detectar desviaciones significativas del comportamiento normal, lo cual es útil para métricas con patrones variables. Esto requiere un historial de datos para establecer una línea base.
- Alertas de disponibilidad: Notifican si el servicio del agente no responde o si el contenedor/instancia está inactivo.
- Alertas de recursos: Se activan si el uso de CPU o memoria excede un porcentaje crítico, indicando posible saturación o problemas de escalabilidad.
Cada alerta debe incluir:
- Descripción clara: Qué está fallando y por qué es importante.
- Contexto: Valores actuales de la métrica, historial reciente, enlaces a dashboards relevantes.
- Acciones sugeridas: Pasos iniciales para la investigación o remediación.
- Severidad: Clasificación del impacto (informativo, advertencia, crítico) para priorizar la respuesta.
Los canales de notificación pueden ser Slack, Microsoft Teams, correo electrónico, PagerDuty o sistemas de gestión de incidentes.
Instrumentación de código para métricas personalizadas
Aunque las plataformas de monitoreo recolectan métricas de infraestructura, para obtener visibilidad granular del comportamiento de LangGraph, a menudo es necesario instrumentar el código directamente. Esto implica añadir llamadas a bibliotecas de métricas en puntos estratégicos del grafo.
from prometheus_client import Histogram, Counter

# Definir métricas (ej. latencia de ejecución, contador de errores)
REQUEST_LATENCY = Histogram('langgraph_request_latency_seconds', 'Tiempo de respuesta del agente LangGraph')
ERROR_COUNT = Counter('langgraph_error_total', 'Errores en la ejecución del agente LangGraph')

@REQUEST_LATENCY.time()
def run_agent(input_data):
    try:
        # Lógica de ejecución del agente LangGraph
        result = agent.invoke(input_data)
        return result
    except Exception as e:
        ERROR_COUNT.inc()
        raise e

# En un nodo específico:
def process_data_node(state):
    start_time = time.time()
    try:
        # Lógica del nodo
        processed_state = {...}
        NODE_LATENCY.labels(node_name='process_data').observe(time.time() - start_time)
        return processed_state
    except Exception as e:
        NODE_ERROR_COUNT.labels(node_name='process_data').inc()
        raise e
Este enfoque permite capturar métricas como la latencia de nodos individuales, el número de veces que se ejecuta un nodo específico o el uso de tokens por interacción. Es crucial para depurar problemas de rendimiento dentro de trayectorias complejas.
Aplicación práctica: Monitoreo en Kubernetes con Prometheus y Grafana
Para un despliegue en Kubernetes, la estrategia común es:
- Instrumentar el agente: Añadir las métricas personalizadas de Prometheus al código Python del agente LangGraph. Exponer estas métricas en un endpoint HTTP (ej.
/metrics) usandoprometheus_client.start_http_server(port).
- Desplegar Prometheus Operator: Instalar Prometheus Operator en el clúster de Kubernetes. Esto facilita la gestión de Prometheus y sus componentes.
- Configurar ServiceMonitor: Crear un recurso
ServiceMonitoren Kubernetes que le indique a Prometheus dónde encontrar el endpoint/metricsde su agente LangGraph. Esto permite que Prometheus haga scraping de las métricas.
- Desplegar Grafana: Instalar Grafana en el clúster y configurarlo para usar Prometheus como fuente de datos. Importar o crear dashboards que visualicen las métricas de rendimiento y comportamiento de su agente.
- Configurar Alertmanager: Integrar Alertmanager (parte del ecosistema Prometheus) para definir las reglas de alerta basadas en PromQL y configurar los receptores (Slack, PagerDuty, etc.).
Esta configuración proporciona un sistema de monitoreo robusto y escalable, esencial para la operación de agentes LangGraph en entornos de producción distribuidos.
There are no comments for now.
to be the first to leave a comment.