Introducción a la producción de agentes LangGraph
Llevar un agente LangGraph de prototipo a producción implica más que la funcionalidad básica. Se requiere una estrategia robusta para la fiabilidad, observabilidad y eficiencia operativa. Esta lección introduce los desafíos clave y las consideraciones para asegurar que los agentes funcionen de manera predecible y escalable en entornos reales.
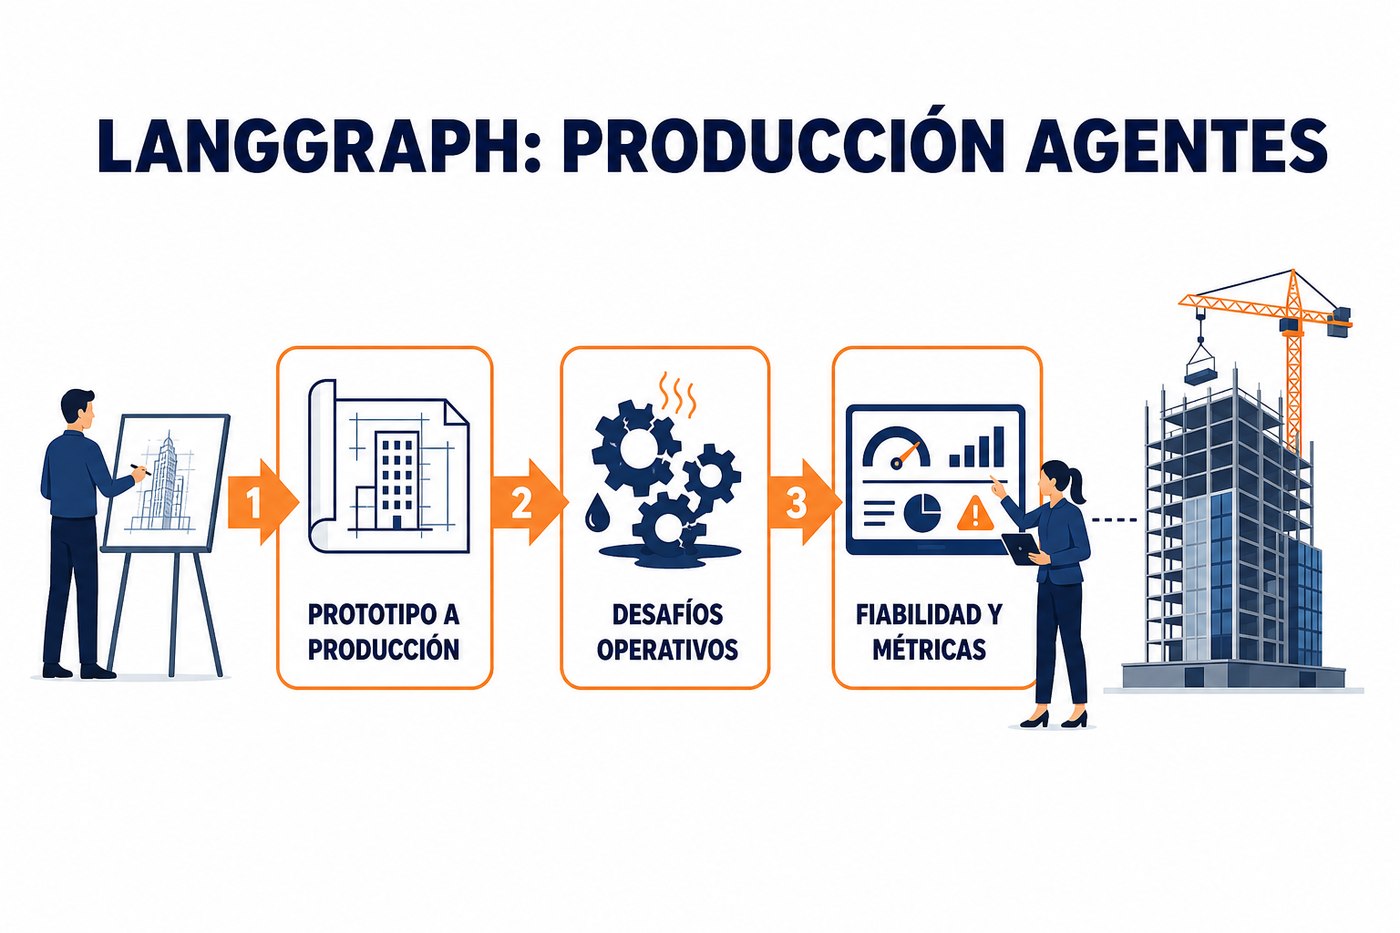
Del Prototipo a la Producción: Cambios de Enfoque
En la fase de prototipado, el objetivo principal es validar la lógica del agente y la interacción con los modelos de lenguaje (LLM). La atención se centra en la funcionalidad y la capacidad de responder a casos de uso específicos. Sin embargo, al pasar a producción, el enfoque se desplaza hacia la estabilidad, el rendimiento, la gestión de errores y la capacidad de monitoreo continuo. Un agente que funciona bien en un entorno controlado puede fallar o degradarse bajo cargas de trabajo reales o con datos inesperados.
La diferencia fundamental radica en la expectativa: un prototipo demuestra qué puede hacer, mientras que un sistema en producción debe demostrar que lo hace de manera consistente, segura y eficiente. Esto implica considerar aspectos que no son críticos durante el desarrollo inicial, como la gestión de recursos, la seguridad y la integración con sistemas existentes.
Desafíos Operativos Clave en Producción
La implementación de agentes LangGraph en producción presenta desafíos multifacéticos que requieren soluciones específicas. Ignorar cualquiera de ellos puede resultar en un agente inestable, costoso o ineficaz. Los principales desafíos incluyen:
- Evaluación y Calidad Continua: Asegurar que el agente mantiene su rendimiento y precisión a lo largo del tiempo, especialmente ante cambios en los LLM subyacentes o en los datos de entrada. Esto requiere la construcción de datasets de prueba representativos y métricas de evaluación automatizadas.
- Observabilidad y Trazabilidad: La complejidad de los grafos de LangGraph hace que sea difícil depurar problemas sin herramientas adecuadas. Es crucial poder rastrear la ejecución de cada paso, las entradas, salidas y las decisiones tomadas por el agente.
- Gestión de Costos y Recursos: Las interacciones con LLM tienen un costo asociado (por token, por llamada). Un agente en producción debe optimizar el uso de tokens y recursos computacionales para ser económicamente viable.
- Fiabilidad y Resiliencia: Los LLM pueden fallar, devolver respuestas inesperadas o tener latencias variables. El agente debe ser capaz de manejar estos escenarios con reintentos, mecanismos de fallback y degradación elegante.
- Latencia y Rendimiento: Las aplicaciones en tiempo real requieren respuestas rápidas. Optimizar la ejecución del grafo para minimizar la latencia es fundamental.
- Seguridad y Cumplimiento: Proteger los datos sensibles, prevenir inyecciones de prompts maliciosos y asegurar que el agente cumple con las políticas de seguridad y privacidad.
- Versionado y Despliegue: Gestionar diferentes versiones del grafo, realizar despliegues sin interrupciones (zero-downtime deployments) y revertir cambios si es necesario.
Métricas Operativas Esenciales
Para gestionar eficazmente un agente en producción, es necesario definir y monitorear un conjunto de métricas operativas. Estas métricas proporcionan información cuantitativa sobre el rendimiento, la fiabilidad y el costo del agente.
| Métrica | Descripción | Importancia Operativa |
|---|---|---|
| Latencia por ejecución | Tiempo total desde la entrada hasta la salida final del agente. | Impacta directamente la experiencia del usuario y la capacidad de respuesta de la aplicación. |
| Costo por ejecución | Costo total de tokens consumidos y recursos computacionales. | Crítico para la viabilidad económica; permite optimizar el uso de LLM y recursos. |
| Tasa de éxito/error | Porcentaje de ejecuciones que completan su tarea sin errores. | Indica la fiabilidad del agente; errores pueden ser por LLM, lógica o integración. |
| Tokens consumidos (input/output) | Número de tokens enviados a y recibidos de los LLM. | Mide la eficiencia de la comunicación con LLM; directamente relacionado con el costo. |
| Uso de memoria/CPU | Recursos computacionales utilizados por el proceso del agente. | Ayuda a dimensionar la infraestructura y detectar fugas de memoria o cuellos de botella. |
| Tasa de reintentos | Frecuencia con la que el agente necesita reintentar una operación. | Indica la inestabilidad de componentes externos (LLM, APIs) o problemas de lógica interna. |
No todas las métricas son igualmente relevantes para cada agente. Prioriza las métricas que reflejan directamente el valor de negocio y los puntos de fallo más probables de tu implementación. Un exceso de métricas puede diluir la visibilidad de los problemas críticos.
Requisitos de Fiabilidad y Tolerancia a Fallos
La fiabilidad de un agente LangGraph en producción se basa en su capacidad para operar de manera consistente, incluso frente a condiciones adversas. Esto implica diseñar el grafo y su entorno para ser tolerante a fallos.
- Manejo de Errores: Implementar bloques
try-exceptrobustos en cada nodo para capturar excepciones y evitar que un fallo en un paso detenga toda la ejecución. Considerar estados de error específicos en el grafo. - Reintentos con Backoff Exponencial: Cuando se interactúa con APIs externas (como LLM o bases de datos), implementar reintentos automáticos con un retardo creciente. Esto evita saturar el servicio externo y permite recuperarse de fallos transitorios.
- Timeouts: Establecer límites de tiempo para las llamadas a LLM y otras operaciones externas. Esto previene que el agente se quede colgado indefinidamente esperando una respuesta.
- Fallback Mechanisms: En caso de que un LLM o una herramienta falle repetidamente, el agente debe tener una estrategia alternativa. Esto podría ser usar un LLM más simple, una respuesta predefinida o escalar el problema a un operador humano.
- Idempotencia: Diseñar los nodos para que puedan ejecutarse múltiples veces con el mismo resultado, sin efectos secundarios indeseados. Esto es crucial para reintentos y recuperación de fallos.
Aplicación Práctica: Preparación Inicial
Para empezar a preparar tu agente LangGraph para producción esta semana, realiza las siguientes acciones:
- Identifica los puntos críticos de fallo: Revisa tu grafo actual e identifica qué nodos dependen de servicios externos (LLM, bases de datos, APIs). Estos son los puntos donde la fiabilidad es más vulnerable.
- Define métricas iniciales: Selecciona las 3-5 métricas operativas más importantes para tu agente (ej. latencia, costo de tokens, tasa de éxito). Piensa cómo podrías empezar a medirlas, aunque sea de forma rudimentaria.
- Esboza un plan de observabilidad: Investiga herramientas de trazabilidad para Python (ej. OpenTelemetry, LangChain Tracing) y considera cómo podrías integrar una para tener visibilidad de las ejecuciones del grafo.
- Documenta expectativas de rendimiento: Discute con el equipo de producto o usuarios finales cuáles son las expectativas de latencia y fiabilidad. Esto te dará objetivos claros para la optimización.
There are no comments for now.
to be the first to leave a comment.