Métricas de rendimiento y calidad para agentes LLM
La evaluación de agentes LLM en producción es crítica para asegurar su desempeño y confiabilidad. Esta lección aborda las métricas cuantitativas y cualitativas esenciales para medir la precisión, relevancia, coherencia y seguridad de las respuestas generadas, permitiendo una toma de decisiones informada sobre su calidad.
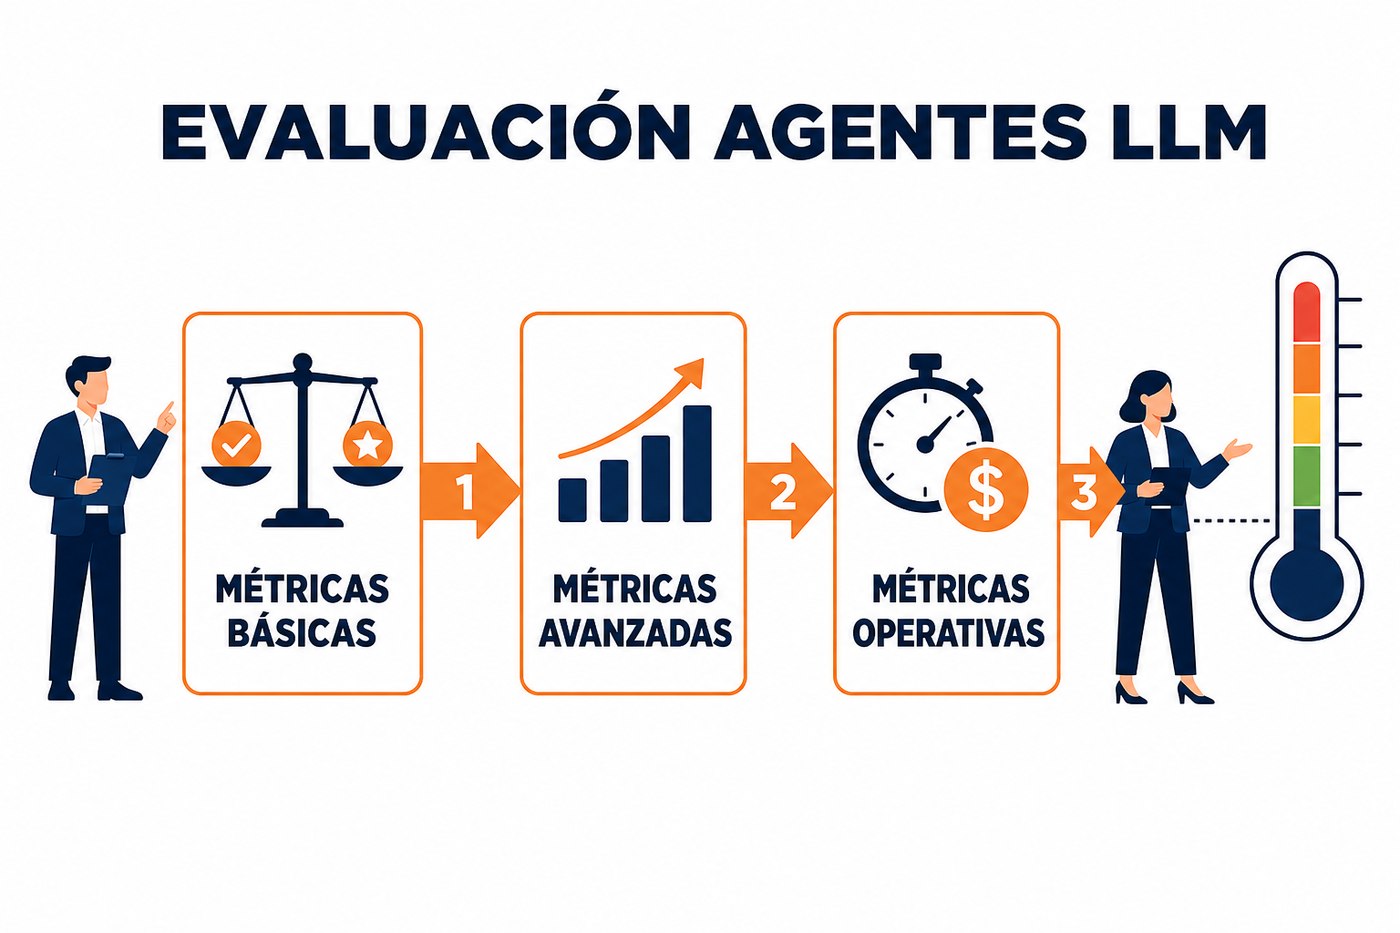
Fundamentos de la evaluación de agentes LLM
Evaluar un agente LLM no es trivial. A diferencia de los sistemas tradicionales con salidas deterministas, los LLM generan texto con variabilidad inherente. Esto requiere un enfoque dual: métricas automáticas para escala y métricas humanas para profundidad y matices. El objetivo es identificar desviaciones del comportamiento esperado y áreas de mejora antes de que impacten la operación.
La evaluación se enfoca en cuatro dimensiones principales:
- Precisión (Factuality): ¿La respuesta es correcta y está libre de alucinaciones?
- Relevancia (Relevance): ¿La respuesta aborda la pregunta o solicitud del usuario de manera directa y útil?
- Coherencia (Coherence): ¿La respuesta es lógicamente consistente, bien estructurada y fácil de entender?
- Seguridad (Safety): ¿La respuesta evita contenido dañino, sesgado o inapropiado?
Métricas cuantitativas para evaluación automática
Las métricas cuantitativas son útiles para monitorear tendencias a gran escala y para pruebas de regresión. Se basan en la comparación de la salida del agente con una "respuesta ideal" o "respuesta de referencia" en un dataset de prueba.
- Exactitud de coincidencia (Exact Match): Mide si la respuesta generada es idéntica a la respuesta de referencia. Útil para preguntas con respuestas únicas y cortas (ej. fechas, nombres). Su limitación es la rigidez; ignora sinónimos o paráfrasis correctas.
- F1 Score (Puntuación F1): Compara la superposición de tokens entre la respuesta generada y la de referencia, calculando la precisión y la recuperación. Es más flexible que Exact Match y se usa comúnmente en tareas de respuesta a preguntas (QA).
- BLEU (Bilingual Evaluation Understudy): Originalmente para traducción automática, mide la superposición de n-gramas. Penaliza las respuestas cortas. Es útil para evaluar la fluidez y la adecuación de la respuesta, aunque su correlación con la calidad humana puede ser limitada.
- ROUGE (Recall-Oriented Understudy for Gisting Evaluation): Se enfoca en la recuperación de n-gramas. Es especialmente útil para tareas de resumen, donde se busca que la respuesta contenga la información clave de la referencia. Existen variantes como ROUGE-N (n-gramas) y ROUGE-L (secuencia más larga común).
- Métricas basadas en incrustaciones (Embeddings-based Metrics): Utilizan modelos de incrustaciones para representar semánticamente la respuesta generada y la de referencia, calculando la similitud coseno. Esto permite evaluar la similitud conceptual, superando las limitaciones de las métricas basadas en palabras clave. Ejemplos incluyen BERTScore o MoverScore.
Ninguna métrica automática captura la calidad humana de forma perfecta. Es crucial entender sus limitaciones y usarlas en conjunto, no de forma aislada. La elección de la métrica depende del tipo de tarea y del comportamiento esperado del agente.
Métricas cualitativas y evaluación humana
La evaluación humana es indispensable para capturar la sutileza, el contexto y la calidad subjetiva de las respuestas. Se realiza mediante la revisión de un subconjunto de respuestas por parte de expertos o anotadores. Esto es particularmente importante para la relevancia, coherencia y seguridad.
- Relevancia: Los evaluadores califican si la respuesta es pertinente a la pregunta, si aborda todos los aspectos clave y si es útil para el usuario. Escalas comunes: "No relevante", "Parcialmente relevante", "Altamente relevante".
- Coherencia y Fluidez: Se evalúa la lógica interna de la respuesta, la ausencia de contradicciones, la estructura gramatical y la facilidad de lectura. Escalas: "Incoherente", "Aceptable", "Excelente".
- Precisión (Factuality): Los evaluadores verifican la veracidad de las afirmaciones en la respuesta, contrastándolas con fuentes confiables si es necesario. Esto es crítico para evitar alucinaciones. Escalas: "Incorrecto", "Parcialmente correcto", "Correcto".
- Seguridad y Sesgo: Se busca la presencia de contenido ofensivo, sesgado, tóxico o inapropiado. También se evalúa si el agente se niega a responder preguntas dañinas o inapropiadas de manera adecuada. Escalas: "Inseguro", "Neutral", "Seguro".
La evaluación humana requiere guías de anotación claras y entrenamiento para los evaluadores, así como mecanismos para calcular la concordancia entre anotadores (ej. Kappa de Cohen) para asegurar la fiabilidad de las calificaciones.
Costo y Latencia: Métricas operativas
Más allá de la calidad de la respuesta, las métricas operativas son fundamentales para la viabilidad en producción. Estas incluyen el costo y la latencia.
- Costo por ejecución: Se mide en función del consumo de tokens (input y output) de los LLM subyacentes. Cada modelo tiene un precio por mil tokens. Es crucial monitorear esto para controlar el presupuesto operativo. Optimizar los prompts, el tamaño de contexto y el número de llamadas a la API impacta directamente en el costo.
- Latencia (Tiempo de respuesta): El tiempo que tarda el agente en generar una respuesta completa. Se mide desde que se recibe la solicitud hasta que se entrega la respuesta final. La latencia impacta directamente la experiencia del usuario. Factores que influyen: complejidad del grafo, número de llamadas a LLM y herramientas externas, tamaño del contexto, velocidad del modelo. Monitorear la latencia promedio, percentiles (ej. P95, P99) y picos es esencial.
Un agente muy preciso pero con alta latencia o costo excesivo puede ser inviable. Se debe buscar un equilibrio entre calidad, costo y rendimiento. La optimización es un proceso iterativo.
Aplicación práctica: ¿Qué hacer el lunes?
Para implementar la evaluación de métricas de rendimiento y calidad en su agente LangGraph:
- Defina objetivos claros: Antes de medir, establezca qué significa "bueno" para su agente. ¿Prioriza la precisión, la velocidad, el costo o una combinación? Esto guiará la selección de métricas.
- Seleccione un subconjunto de métricas: No es necesario aplicar todas. Para tareas de QA, empiece con F1 Score y una métrica de incrustaciones. Para resúmenes, use ROUGE. Siempre incluya métricas de costo y latencia.
- Establezca un proceso de evaluación humana: Diseñe plantillas de evaluación para que los expertos califiquen la relevancia, coherencia, precisión y seguridad de las respuestas. Comience con un pequeño volumen de datos para refinar el proceso.
- Integre las métricas en su pipeline de CI/CD: Automatice la ejecución de las métricas cuantitativas contra su dataset de prueba con cada cambio significativo en el grafo o los prompts. Establezca umbrales de aceptación para estas métricas.
- Monitoree continuamente: Una vez en producción, utilice herramientas de observabilidad (como LangSmith, tema de la siguiente lección) para recolectar datos sobre el costo, la latencia y las trazas de ejecución. Esto permitirá identificar degradaciones de rendimiento y calidad en tiempo real.
There are no comments for now.
to be the first to leave a comment.