Ollama y modelos locales
Ollama permite ejecutar LLMs y modelos de embedding en tu propio hardware, sin enviar datos a la nube.
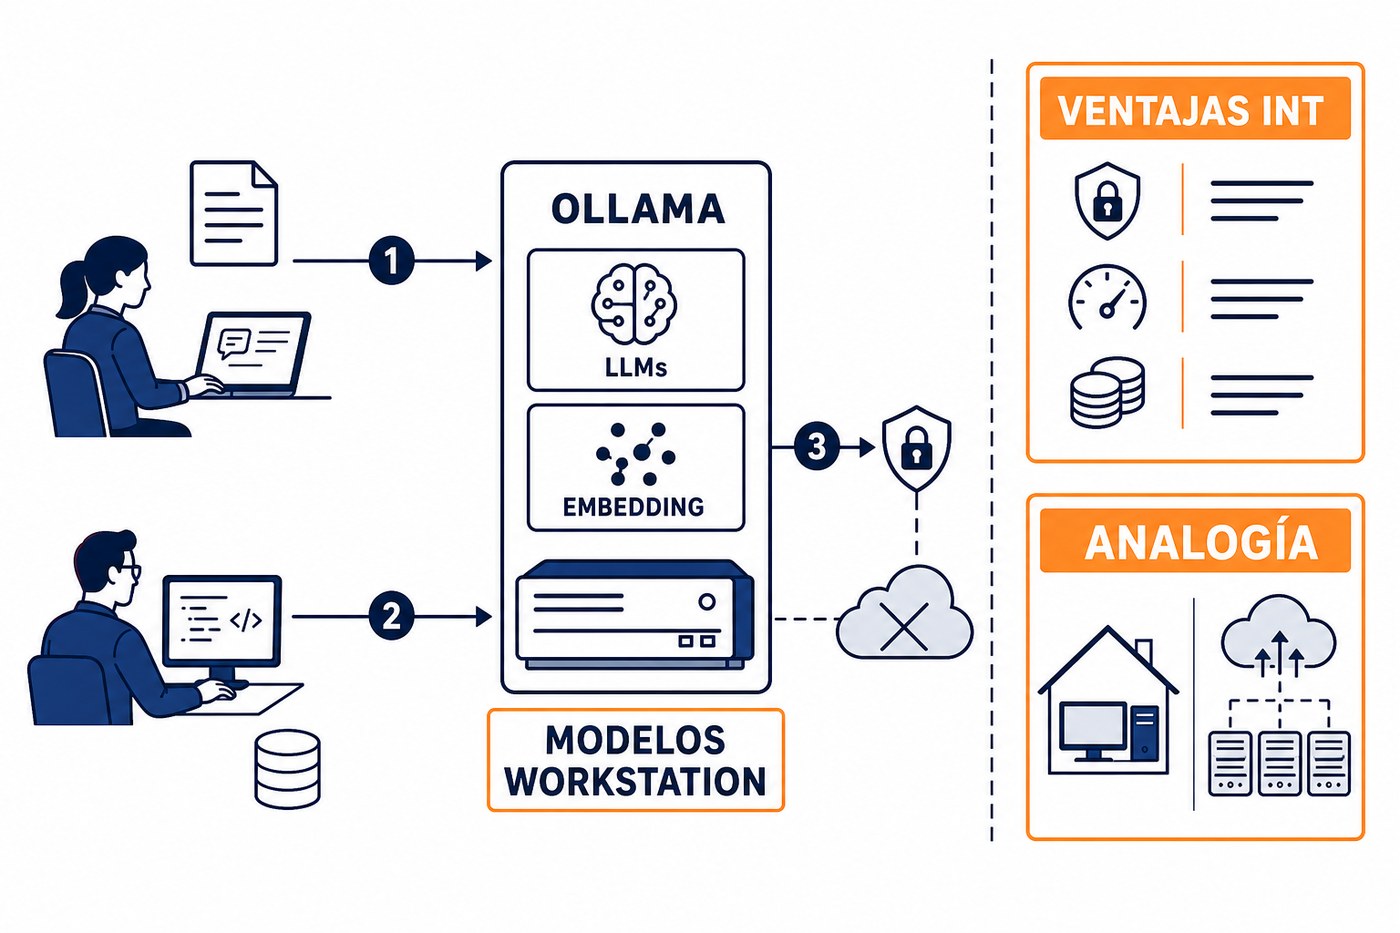
Ventajas para INT
- Privacidad total: las licitaciones y datos internos no salen de tu red.
- Costo marginal cero: sin pago por token.
- Control: eliges versión, cuantización y parámetros.
- Offline: funciona sin internet.
Modelos en la workstation
- qwen3:32b — generación de reportes (LicitIA).
- llama3.3:70b — razonamiento pesado.
- bge-m3 — embeddings multilingües.
- nomic-embed-text — embeddings ligeros.
HARDWARE
las 2× RTX 5090 de la workstation aceleran inferencia y embeddings por GPU.
Calificación
No hay comentarios por ahora.
para ser el primero en comentar.