Construye un mini-RAG
Cerramos con un mini-RAG funcional en ~20 líneas para que veas el flujo completo.
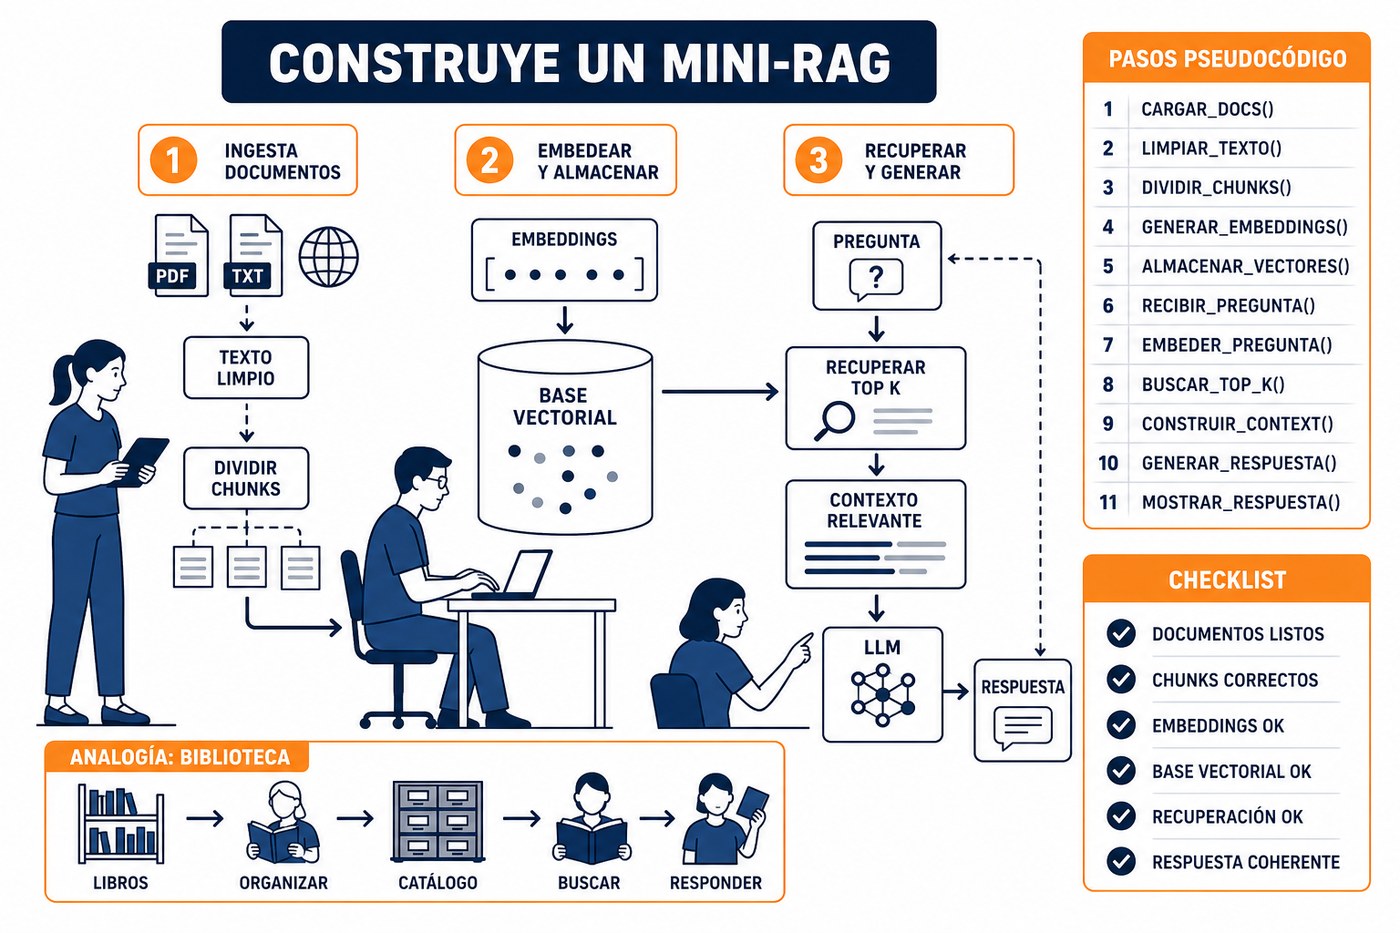
Pasos en pseudocódigo
# 1. Cargar y dividir
docs = cargar_pdfs("licitaciones/")
chunks = dividir(docs, tamano=500, overlap=50)

# 2. Incrustar y guardar
embeddings = modelo_embed(chunks)      # bge-m3
bd = Chroma()
bd.agregar(chunks, embeddings)

# 3. Consultar
pregunta = "¿Cuál es el objeto de la licitación X?"
v = modelo_embed([pregunta])
relevantes = bd.buscar(v, top_k=4)     # 4 chunks

# 4. Generar
respuesta = llm(prompt_con_contexto(relevantes, pregunta))
Checklist
- ¿Chunking con solapamiento adecuado?
- ¿Embeddings del mismo modelo para indexar y consultar?
- ¿top-k razonable (3–8)?
- ¿El prompt exige responder solo del contexto?
- ¿Guardas metadatos para citar la fuente?
SIGUIENTE
el curso de Agentes de IA lleva este RAG a sistemas autónomos que encadenan múltiples pasos.
Calificación
No hay comentarios por ahora.
para ser el primero en comentar.