Métricas de Rendimiento: Latencia y Throughput en NIM
La optimización del rendimiento en la inferencia de modelos de IA es crítica. Esta lección define y diferencia latencia y throughput, dos métricas fundamentales para evaluar y mejorar el desempeño de los microservicios NVIDIA NIM. Comprender su interacción es clave para un dimensionamiento y operación eficientes.
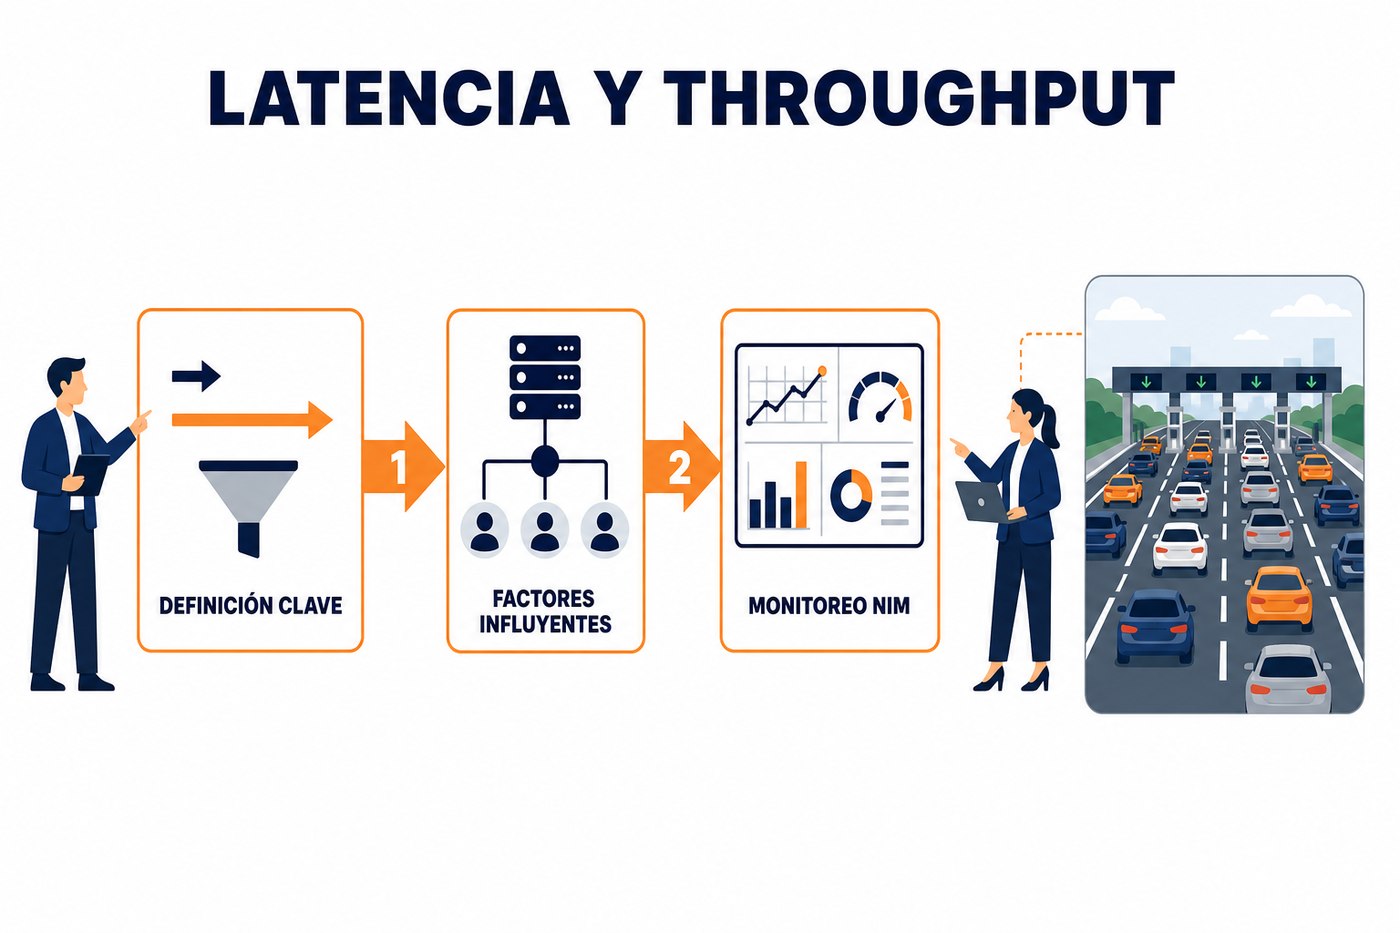
Diferencia entre Latencia y Throughput
En el contexto de la inferencia de modelos de IA, la latencia se refiere al tiempo que tarda un sistema en responder a una solicitud individual. Es el retraso entre el momento en que se envía una entrada al modelo y el momento en que se recibe la salida correspondiente. Se mide típicamente en milisegundos (ms). Una baja latencia es crucial para aplicaciones interactivas o en tiempo real, donde la percepción del usuario o la respuesta del sistema depende de una contestación rápida.
Por otro lado, el throughput (o rendimiento) mide la cantidad de solicitudes de inferencia que un sistema puede procesar en una unidad de tiempo. Se expresa comúnmente en inferencias por segundo (IPS) o solicitudes por segundo (RPS). Un alto throughput es vital para cargas de trabajo por lotes o aplicaciones que procesan un gran volumen de datos, donde la capacidad total del sistema es más importante que la respuesta individual a cada solicitud.
| Métrica | Definición | Unidad de Medida Común | Aplicación Típica |
|---|---|---|---|
| Latencia | Tiempo de respuesta por solicitud individual | Milisegundos (ms) | Chatbots, conducción autónoma, asistentes de voz |
| Throughput | Número de solicitudes procesadas por unidad de tiempo | Inferencias/segundo (IPS), solicitudes/segundo (RPS) | Procesamiento de imágenes por lotes, análisis de logs, generación de contenido |
Factores que Influyen en Latencia y Throughput
Diversos factores afectan estas métricas en un despliegue NIM:
- Modelo de IA: La complejidad del modelo (número de parámetros, tipo de operaciones) impacta directamente el tiempo de cómputo y, por ende, la latencia. Modelos más grandes o complejos requieren más recursos y tiempo.
- Hardware de GPU: La capacidad de procesamiento de la GPU (núcleos CUDA, memoria, ancho de banda) es fundamental. GPUs más potentes pueden procesar inferencias más rápido y manejar mayor concurrencia.
- Tamaño del Lote (Batch Size): Procesar múltiples solicitudes en un solo lote puede aumentar significativamente el throughput al mejorar la utilización de la GPU, pero generalmente incrementa la latencia por solicitud individual, ya que todas las inferencias del lote deben completarse antes de que cualquier resultado sea devuelto.
- Concurrencia: El número de solicitudes paralelas que el microservicio NIM puede manejar simultáneamente. Una mayor concurrencia puede aumentar el throughput hasta el punto de saturación de la GPU o la memoria.
- Optimización del modelo: Técnicas como la cuantificación, la poda (pruning) o el uso de TensorRT pueden reducir la latencia y aumentar el throughput al hacer el modelo más eficiente.
- Overhead de red y software: El tiempo de transmisión de datos, la sobrecarga del sistema operativo, el contenedor Docker y el propio microservicio NIM contribuyen a la latencia total.
Monitoreo de Métricas en Despliegues NIM
NVIDIA NIM, al estar basado en contenedores, se integra bien con herramientas de monitoreo estándar. Es crucial instrumentar el sistema para recopilar datos de latencia y throughput.
- Métricas de GPU: Utiliza herramientas como
nvidia-smipara monitorear la utilización de la GPU, el uso de memoria y la temperatura. Estas métricas son indicadores clave de posibles cuellos de botella. - Métricas de Contenedor: Las plataformas de orquestación como Kubernetes o herramientas como cAdvisor proporcionan métricas de CPU, memoria y E/S a nivel de contenedor.
- Métricas de Microservicio NIM: Los microservicios NIM exponen métricas Prometheus. Esto permite integrar fácilmente el monitoreo con Grafana para visualizar la latencia promedio, percentiles de latencia (p90, p99), throughput (IPS/RPS) y errores. La documentación específica del microservicio NIM que estés utilizando indicará los endpoints de métricas.
Prioriza la métrica relevante para tu caso de uso. Si tu aplicación es interactiva, la latencia (especialmente p99) es primordial. Si procesas grandes volúmenes offline, el throughput es el objetivo principal. No intentes optimizar ambas al máximo simultáneamente, ya que a menudo son inversamente proporcionales.
Ejemplo Básico de Monitoreo con cURL y Prometheus
Para una prueba rápida de latencia, puedes usar curl y medir el tiempo de respuesta. Para un monitoreo continuo, Prometheus es la herramienta estándar.
# Prueba de latencia básica a un endpoint de inferencia NIM
# Asume que tu microservicio NIM está corriendo en localhost:8000

time curl -X POST \
  -H "Content-Type: application/json" \
  -d '{"inputs": [{"name": "input_ids", "shape": [1, 10], "datatype": "INT32", "data": [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]}]}' \
  http://localhost:8000/v2/models/your_model_name/infer

# Para monitoreo Prometheus, configura el scraper en prometheus.yml
# y apunta al puerto de métricas de tu contenedor NIM (ej. 8002)

# Ejemplo de configuración en prometheus.yml:
# - job_name: 'nim_inference_service'
#   static_configs:
#     - targets: ['localhost:8002'] # Ajusta el puerto según tu despliegue NIM
Los microservicios NIM exponen métricas en el formato de Prometheus. Generalmente, estas métricas incluyen contadores de solicitudes, histogramas de latencia y utilización de recursos. Al integrar estos datos con Grafana, puedes crear paneles de control que visualicen en tiempo real el rendimiento de tus despliegues.
Aplicación Práctica: Qué Hacer el Lunes
- Identifica la métrica clave: Para tu proyecto actual, define si la baja latencia o el alto throughput es más crítico. Esto guiará tus decisiones de configuración y optimización.
- Configura monitoreo básico: Si aún no lo tienes, implementa un monitoreo de GPU (
nvidia-smi) y del microservicio NIM (endpoints Prometheus) para tu entorno de desarrollo o pruebas. Utiliza Grafana para visualizar las métricas. - Realiza pruebas de carga: Con herramientas como Apache JMeter o Locust, simula diferentes cargas de trabajo (variando el número de usuarios concurrentes y el tamaño del lote) para entender cómo el microservicio NIM se comporta bajo estrés y cómo latencia y throughput se ven afectados.
- Documenta tus hallazgos: Registra las métricas de rendimiento obtenidas con diferentes configuraciones de batch size y concurrencia. Esta información es fundamental para el dimensionamiento de producción y para futuras optimizaciones.
No hay comentarios por ahora.
para ser el primero en comentar.