Implementación de Modelos en Azure AI Foundry: Endpoints y Configuraciones
Esta lección detalla la implementación de modelos desde el catálogo de Azure AI Foundry. Se cubre la configuración de endpoints para inferencia, especificando parámetros clave como tipo de instancia y escalabilidad, para asegurar un despliegue operativo y eficiente.
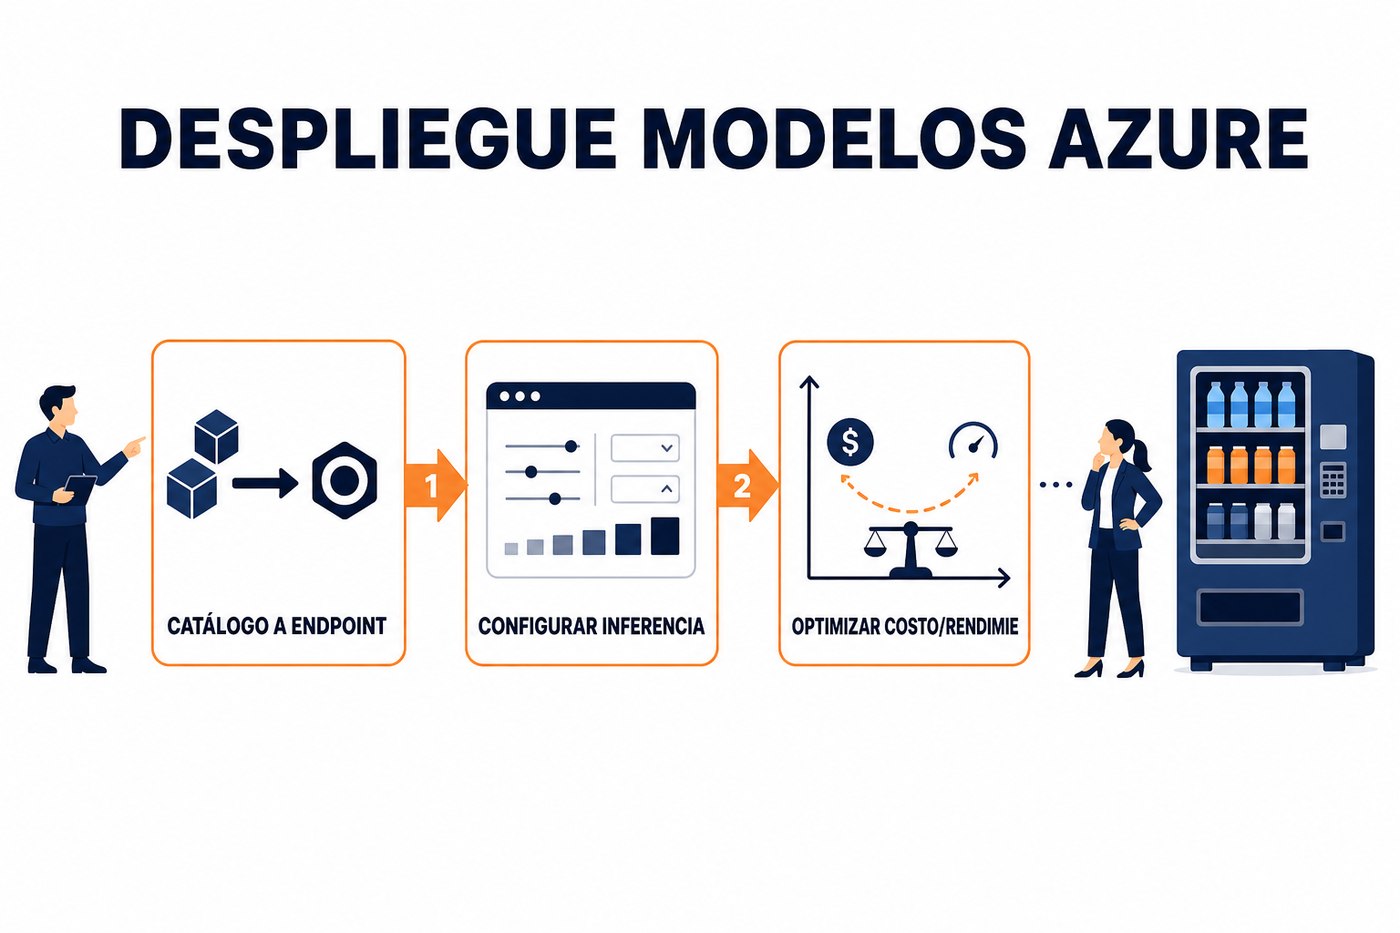
El proceso de despliegue: del catálogo al endpoint
Una vez seleccionado un modelo del catálogo de Azure AI Foundry, el siguiente paso es hacerlo accesible para inferencia. Esto se logra mediante la creación de un endpoint de despliegue. Un endpoint es una URL a la que se envían las solicitudes de inferencia, y detrás de ella, Azure AI Foundry gestiona los recursos computacionales necesarios para ejecutar el modelo.
El proceso de despliegue no es una simple activación; implica la configuración de infraestructura subyacente que ejecutará el modelo. Esto incluye la selección del tipo de máquina virtual (VM), la definición de los parámetros de escalabilidad y la especificación de cómo el modelo debe ser cargado y ejecutado. La decisión sobre estos parámetros impacta directamente en el rendimiento, la latencia y el costo operativo.
Configuración de Endpoints para Inferencia
La configuración de un endpoint es un paso crítico que determina la eficiencia y disponibilidad del modelo. Los principales parámetros a considerar son:
- Nombre del Endpoint: Identificador único para acceder al modelo. Debe ser descriptivo y seguir las convenciones de nomenclatura internas.
- Tipo de Despliegue: Se refiere a si el despliegue es en tiempo real (real-time endpoint) o por lotes (batch endpoint). Los endpoints en tiempo real están optimizados para baja latencia y solicitudes individuales, mientras que los de lotes son para procesar grandes volúmenes de datos de forma asíncrona.
- Modelo Base: El modelo seleccionado del catálogo de Azure AI Foundry. Se especifica la versión exacta del modelo para asegurar consistencia.
- Entorno de Cómputo: Define la infraestructura subyacente. Puede ser una instancia de Azure Machine Learning Compute, un clúster de Kubernetes o una instancia dedicada. La elección depende de los requisitos de rendimiento, escalabilidad y costo.
- Tipo de Instancia: La VM específica que alojará el modelo. Se seleccionan según la cantidad de CPU, GPU y memoria RAM. Por ejemplo, una VM con GPU es necesaria para modelos de visión o lenguaje grandes, mientras que modelos más pequeños pueden correr en CPU. La disponibilidad de tipos de instancia varía por región de Azure.
- Configuración de Escalabilidad: Incluye el número mínimo y máximo de instancias para el despliegue. Esto permite que el endpoint se escale automáticamente según la demanda. Un número mínimo de instancias asegura disponibilidad, mientras que el máximo controla el gasto. También se pueden configurar umbrales de uso de CPU/GPU para el autoescalado.
Siempre valide los tipos de instancia disponibles en la región de Azure donde se planea el despliegue. Las capacidades varían y un tipo de instancia no disponible generará un error de despliegue.
Parámetros de Despliegue y Optimización
Además de la configuración básica, existen parámetros avanzados que permiten optimizar el despliegue para casos de uso específicos:
- Contenedor Docker: Para modelos personalizados o con dependencias específicas, se puede proporcionar una imagen Docker. Azure AI Foundry también genera imágenes preconfiguradas para muchos modelos del catálogo.
- Variables de Entorno: Permiten configurar el comportamiento del modelo o de la aplicación de inferencia en tiempo de ejecución. Útil para credenciales, rutas de archivos o flags de configuración.
- Configuración de Liveness y Readiness Probes: Esencial para asegurar la resiliencia del servicio. Las liveness probes verifican si el contenedor está funcionando, mientras que las readiness probes indican si el contenedor está listo para recibir tráfico. Esto es crítico en entornos de autoescalado y actualizaciones.
- Configuración de Tráfico: Permite dirigir un porcentaje del tráfico a diferentes versiones de un despliegue (despliegue azul/verde o A/B testing). Esto es útil para probar nuevas versiones de modelos en producción con un subconjunto de usuarios antes de un despliegue completo.
El despliegue se puede realizar a través del portal de Azure, la CLI de Azure o el SDK de Python. Para automatización y despliegues repetibles, se recomienda el uso de la CLI o el SDK.
az ai model deploy create \
  --resource-group <nombre-rg> \
  --project <nombre-proyecto> \
  --name <nombre-despliegue> \
  --model-id <id-modelo> \
  --instance-type <tipo-instancia> \
  --instance-count 1 \
  --endpoint-name <nombre-endpoint>
Consideraciones de Costo y Rendimiento
La elección del tipo de instancia y la configuración de escalabilidad tienen un impacto directo en el costo. Instancias con GPU son significativamente más caras que las CPU. Es fundamental balancear el rendimiento requerido con el presupuesto disponible. El monitoreo continuo de los endpoints es necesario para identificar oportunidades de optimización.
- Subutilización: Si un despliegue usa pocas instancias o instancias muy potentes para una carga de trabajo baja, se incurre en costos innecesarios. Ajustar el número mínimo de instancias o el tipo de VM puede reducir el gasto.
- Sobreutilización: Si el despliegue está constantemente al límite de su capacidad, puede haber latencia alta o errores. Esto indica la necesidad de escalar a más instancias o a tipos de VM más potentes.
Azure AI Foundry proporciona herramientas de monitoreo integradas que permiten visualizar el uso de recursos y el rendimiento del endpoint. Estas métricas son cruciales para tomar decisiones informadas sobre la optimización de costos y rendimiento.
Aplicación práctica: ¿Qué hacer el lunes?
El lunes, seleccione un modelo del catálogo de Azure AI Foundry que considere relevante para un caso de uso hipotético en INT. Proceda a crear un despliegue de tipo real-time endpoint. Durante la configuración:
- Elija un tipo de instancia de CPU (por ejemplo, Standard_DS3_v2) para empezar, para minimizar el costo inicial.
- Configure el número mínimo de instancias en 1 y el máximo en 2.
- Observe el proceso de despliegue y el tiempo que tarda en estar listo el endpoint.
- Una vez desplegado, identifique la URL del endpoint y la clave de autenticación. No es necesario realizar inferencias en este punto, solo verificar la accesibilidad del endpoint.
- Revise las métricas básicas de uso del endpoint en el portal de Azure para familiarizarse con la información disponible.
Este ejercicio le permitirá entender el flujo de trabajo de despliegue y los parámetros clave involucrados antes de pasar a la evaluación del modelo en la siguiente lección.
There are no comments for now.
to be the first to leave a comment.