Uso de bases de datos vectoriales en RAG
La implementación de RAG (Retrieval Augmented Generation) mejora la precisión de los LLM al integrar información externa. Para manejar grandes volúmenes de datos y consultas complejas, las bases de datos vectoriales son fundamentales. Esta lección explica su rol, funcionamiento y cómo integrarlas eficazmente en arquitecturas RAG para escalabilidad y relevancia semántica.
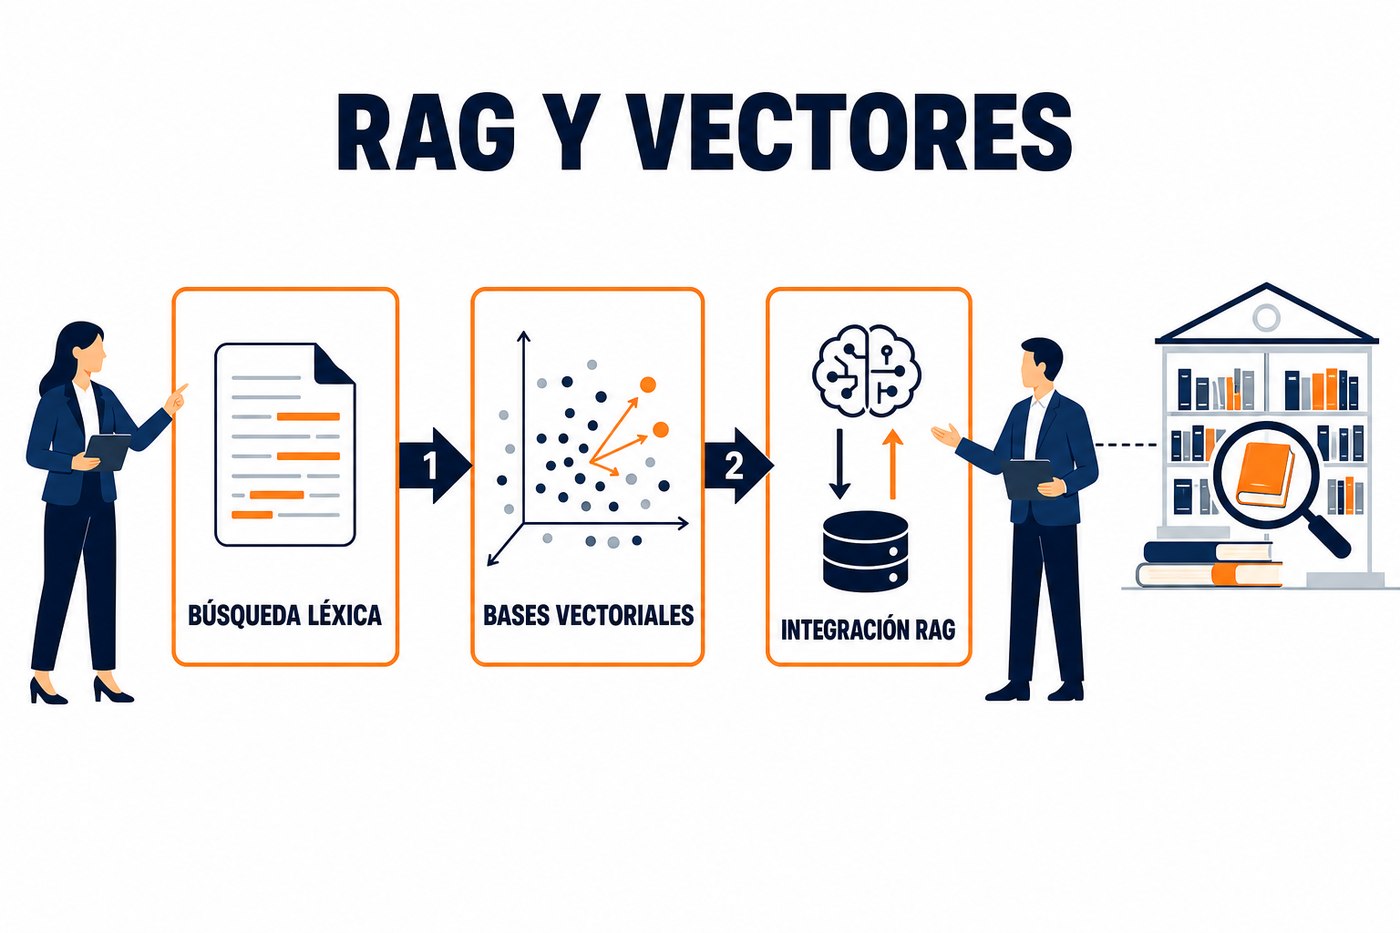
Limitaciones de la búsqueda léxica en RAG
La búsqueda léxica tradicional, como la que emplean los sistemas basados en palabras clave (ej. TF-IDF, BM25), es efectiva para encontrar coincidencias exactas o parciales de términos. Sin embargo, en el contexto de RAG, presenta limitaciones significativas. No comprende el significado subyacente de las palabras ni las relaciones semánticas entre ellas. Esto significa que una consulta que use sinónimos o frases con el mismo significado pero distinta redacción podría no recuperar los documentos más relevantes.
Por ejemplo, si un usuario pregunta '¿Cuál es el proceso para dar de alta un nuevo empleado?', un sistema léxico podría no encontrar documentos que hablen de 'onboarding de personal' si no contienen las palabras exactas 'dar de alta' o 'nuevo empleado'. Esta falta de comprensión contextual reduce la calidad del contexto proporcionado al LLM, impactando la pertinencia y precisión de la respuesta generada.
Introducción a las bases de datos vectoriales
Las bases de datos vectoriales almacenan información como embeddings, que son representaciones numéricas de texto (o imágenes, audio, etc.) en un espacio multidimensional. Cada embedding captura el significado semántico del contenido original. Documentos o fragmentos con significados similares estarán 'cerca' uno del otro en este espacio vectorial.
Cuando un usuario realiza una consulta, esta también se convierte en un embedding. La base de datos vectorial compara el embedding de la consulta con los embeddings almacenados para encontrar los documentos más semánticamente similares. Este proceso se conoce como búsqueda de vecinos más cercanos (Nearest Neighbor Search) o, más comúnmente, búsqueda de vecinos más cercanos aproximados (Approximate Nearest Neighbor, ANN) para conjuntos de datos grandes y eficientes.
Vertex AI Vector Search es la solución de Google Cloud para este propósito. Ofrece una infraestructura escalable y gestionada para almacenar y buscar embeddings de alta dimensionalidad. Permite la indexación de millones o miles de millones de vectores y realiza búsquedas de baja latencia, lo cual es crítico para aplicaciones RAG en tiempo real.
- Generación de embeddings: Los documentos de la fuente de datos se dividen en fragmentos y cada fragmento se procesa mediante un modelo de embedding (ej. modelos de texto de Vertex AI) para generar su representación vectorial.
- Indexación: Estos vectores se almacenan en la base de datos vectorial, donde se indexan para permitir búsquedas eficientes.
- Consulta: La consulta del usuario se convierte en un embedding y se utiliza para buscar los vectores más similares en la base de datos.
- Recuperación: Los fragmentos de texto correspondientes a los vectores recuperados se envían al LLM como contexto adicional.
Ventajas de Vertex AI Vector Search para RAG
La integración de Vertex AI Vector Search en una arquitectura RAG ofrece beneficios operativos clave:
- Relevancia semántica: Supera las limitaciones de la búsqueda por palabras clave al encontrar información relevante incluso si la redacción es diferente, pero el significado es el mismo. Esto mejora la calidad del contexto para el LLM.
- Escalabilidad: Diseñado para manejar grandes volúmenes de datos y un alto número de consultas concurrentes, lo que es esencial para entornos empresariales con extensas bases de conocimiento.
- Baja latencia: Las búsquedas ANN permiten recuperar resultados en milisegundos, fundamental para una experiencia de usuario fluida con LLM interactivos.
- Flexibilidad de datos: Puede indexar embeddings de diversos tipos de contenido (texto, imágenes, audio) si se usan los modelos de embedding adecuados, permitiendo RAG multimodal.
- Gestión simplificada: Al ser un servicio gestionado de Google Cloud, reduce la carga operativa de configurar y mantener infraestructura de bases de datos vectoriales.
La elección del modelo de embedding es tan crítica como la base de datos vectorial. Un embedding de baja calidad resultará en una búsqueda semántica deficiente, independientemente de la eficiencia de la base de datos. Evalúe y seleccione modelos que estén pre-entrenados o finamente ajustados para el dominio de sus datos.
Integración con Vertex AI Search y otros componentes
Vertex AI Search, como se vio en la lección anterior, ya incorpora capacidades de búsqueda semántica. Sin embargo, para escenarios que requieren un control más granular sobre la indexación, el manejo de grandes volúmenes de embeddings o la integración con flujos de trabajo de datos complejos, Vertex AI Vector Search se convierte en una herramienta complementaria o alternativa. Puede utilizarse para:
- Creación de índices personalizados: Para datos que no se ajustan directamente a los conectores predefinidos de Vertex AI Search o requieren preprocesamiento específico.
- Combinación de fuentes: Integrar resultados de Vertex AI Vector Search con otras fuentes de información o sistemas de búsqueda para una recuperación híbrida.
- Casos de uso avanzados: Como recomendación de productos, detección de anomalías o búsqueda de similitud en datos no textuales, donde la capacidad de indexar y buscar embeddings puros es fundamental.
La arquitectura típica implica:
- Ingesta de datos: Los documentos se cargan en un bucket de Cloud Storage o BigQuery.
- Generación de embeddings: Un pipeline (ej. Dataflow, Cloud Functions) utiliza un modelo de embedding de Vertex AI para transformar los fragmentos de texto en vectores.
- Carga a Vector Search: Los embeddings se cargan en un índice de Vertex AI Vector Search.
- Consulta RAG: La aplicación del usuario envía la consulta, se genera su embedding, se busca en Vector Search para recuperar los fragmentos relevantes y estos se pasan al LLM de Vertex AI para la generación de la respuesta.
Consideraciones de costos y cuotas
El uso de Vertex AI Vector Search implica costos asociados con el almacenamiento de los índices y las operaciones de consulta. Los costos de almacenamiento se basan en el tamaño del índice (en GB), mientras que los costos de consulta se basan en el número de consultas por segundo (QPS) y el volumen de datos procesados. Es fundamental monitorear el uso y optimizar el tamaño de los embeddings y la estrategia de indexación.
Las cuotas de Vertex AI Vector Search aplican límites al número de índices, el tamaño máximo del índice y el QPS máximo. Antes de desplegar soluciones a gran escala, revise las cuotas predeterminadas y solicite aumentos si es necesario, especialmente para proyectos con requisitos de alto rendimiento o grandes volúmenes de datos.
Aplicación práctica: Preparación para el lunes
Para integrar eficazmente las bases de datos vectoriales en sus proyectos RAG, considere los siguientes pasos:
- Identifique su fuente de datos: Determine qué documentos o bases de conocimiento se beneficiarían de la búsqueda semántica. Si su contenido es extenso y requiere alta precisión, Vertex AI Vector Search es una opción a evaluar.
- Seleccione un modelo de embedding: Pruebe diferentes modelos de texto de Vertex AI para ver cuál genera los embeddings más relevantes para su dominio. Puede experimentar con modelos pre-entrenados o considerar el ajuste fino para casos muy específicos.
- Diseñe su pipeline de ingesta: Planifique cómo se fragmentarán sus documentos, se generarán los embeddings y se cargarán en Vertex AI Vector Search. Considere la automatización de este proceso para mantener el índice actualizado.
- Estime costos y cuotas: Realice un cálculo aproximado de los costos de almacenamiento y consulta basándose en el volumen de datos y el tráfico esperado. Verifique las cuotas actuales de su proyecto y planifique con anticipación si necesita aumentos.
There are no comments for now.
to be the first to leave a comment.