Transformers y atención
La arquitectura Transformer (Google, 2017, "Attention is all you need") es la base de los LLM modernos.
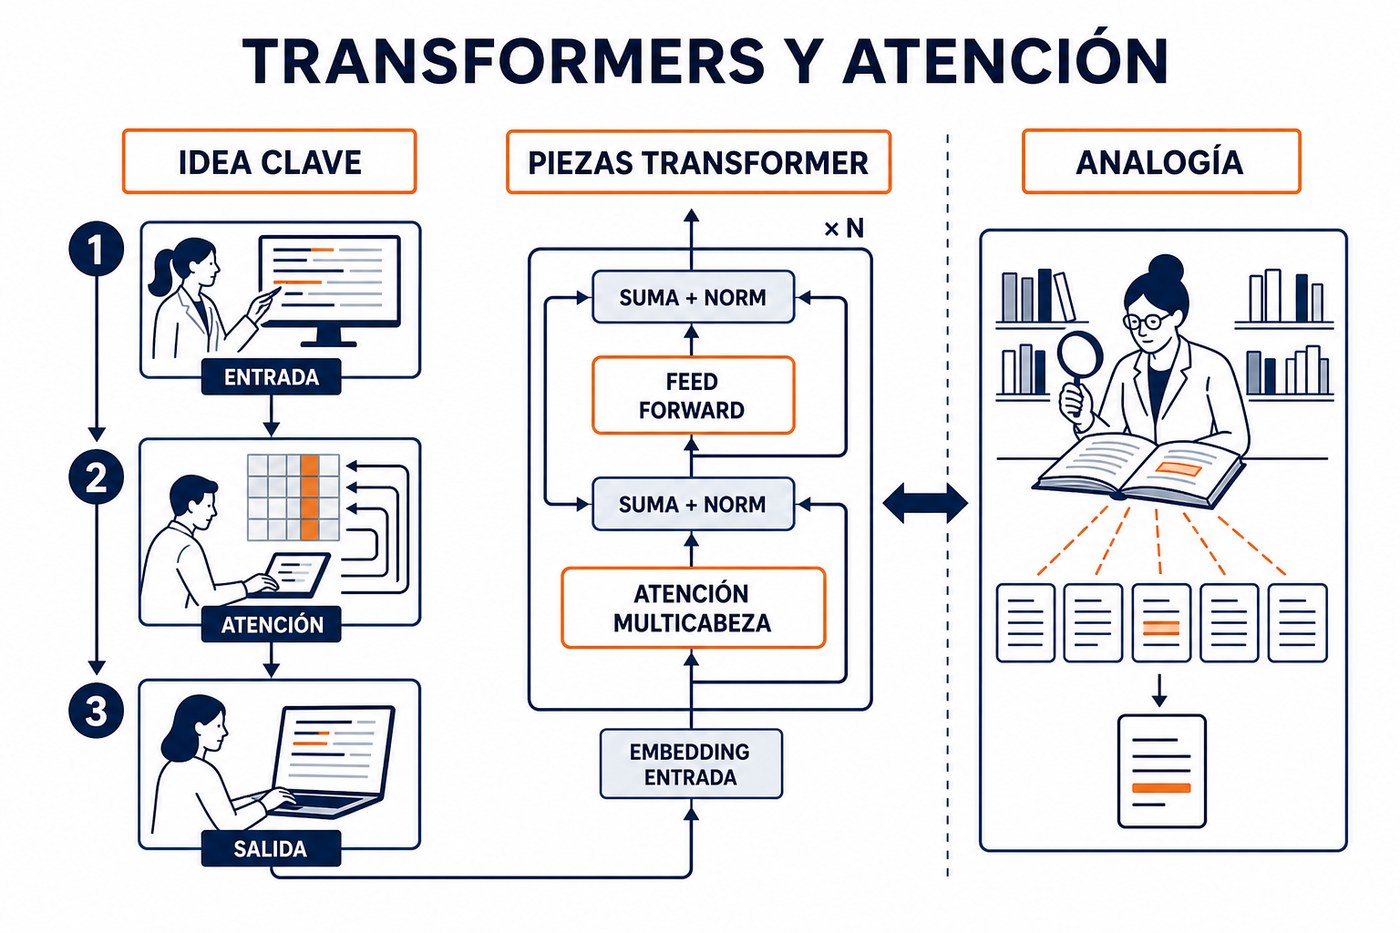
Arquitectura Transformer: tokens → atención → predicción del siguiente token.
La idea clave: atención
La self-attention permite que cada token "mire" a todos los demás y decida a cuáles prestar más peso según el contexto.
- En "el banco del río" vs "fui al banco a depositar", la palabra "banco" se desambigua por atención al contexto.
- Permite capturar dependencias de largo alcance en el texto.
Piezas del Transformer
- Embeddings + posición: token → vector + su orden.
- Multi-head attention: varias "cabezas" que atienden aspectos distintos.
- Feed-forward + residual: transforman y estabilizan la señal.
- Softmax final: convierte en probabilidades del siguiente token.
DATO
los transformadores se procesan en paralelo (a diferencia de las RNN), por eso escalan a modelos gigantes.
Rating
There are no comments for now.
to be the first to leave a comment.