Control de Costos y Rate Limits en Integraciones
La integración de OpenClaw con APIs externas y servicios de IA introduce variables de costo y rendimiento. Esta lección detalla cómo monitorear y controlar los gastos, así como gestionar los límites de tasa (rate limits) para asegurar la estabilidad y eficiencia operativa.
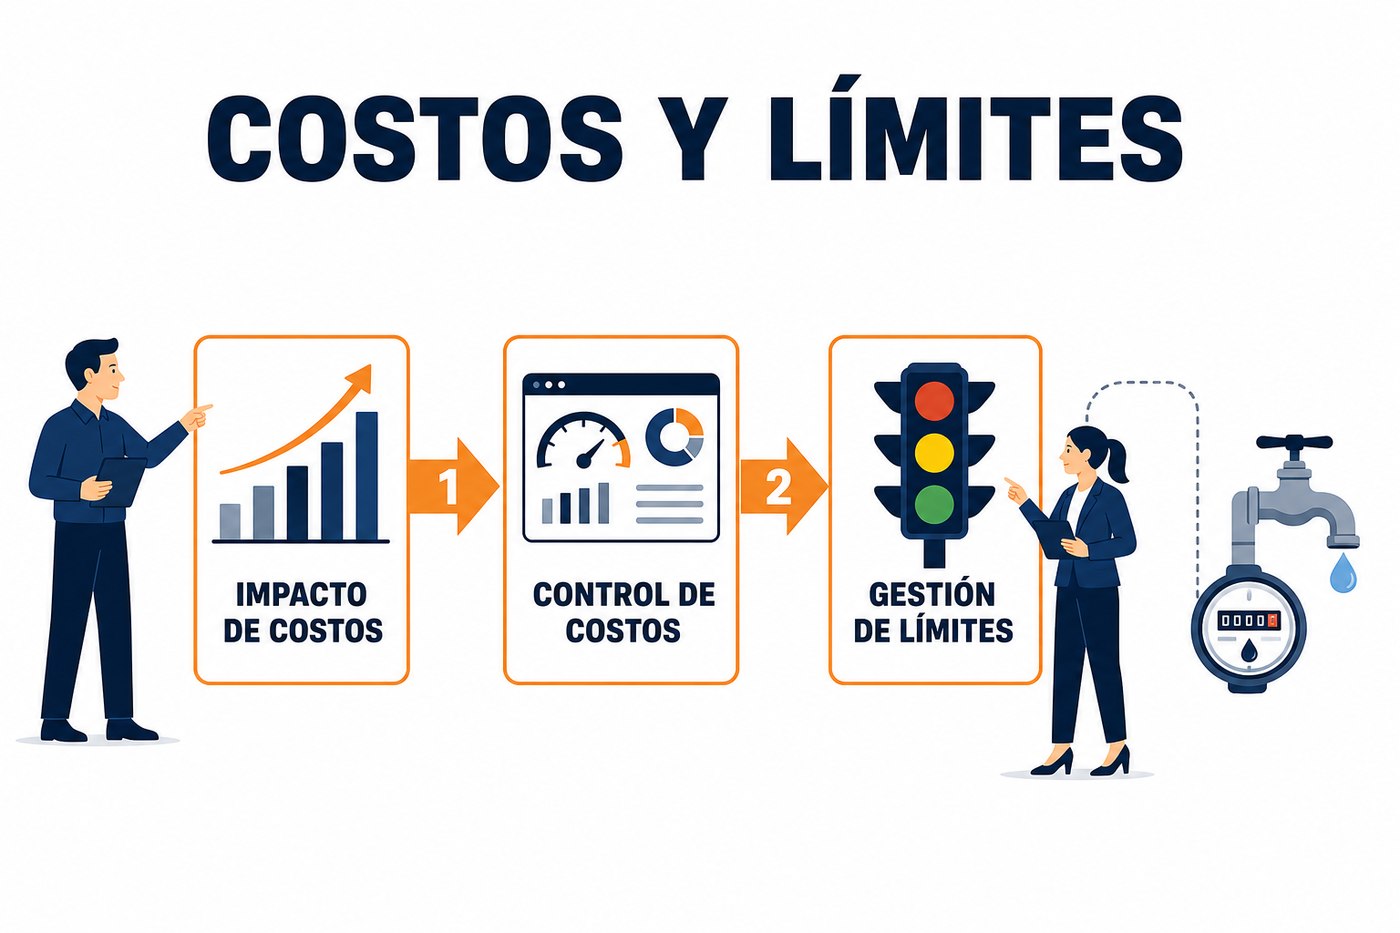
Impacto de Costos en Integraciones de IA y APIs
El uso de servicios de inteligencia artificial (IA) y APIs externas no es gratuito. Los proveedores cobran por el consumo, que puede medirse por tokens procesados, llamadas a la API, tiempo de cómputo, o volumen de datos. Comprender estos modelos de facturación es el primer paso para controlar el gasto. Un skill de OpenClaw que interactúa con un modelo de lenguaje grande (LLM) o un servicio de generación de imágenes puede incurrir en costos significativos si no se gestiona adecuadamente.
Los costos se escalan con el uso. Una skill que se ejecuta cientos o miles de veces al día, incluso con un costo unitario bajo, puede generar una factura elevada. La optimización del diseño de la skill para minimizar las llamadas a APIs externas o el procesamiento de datos innecesarios es crucial.
Estrategias de Control de Costos
- Monitoreo Activo: Implementar herramientas de monitoreo de costos ofrecidas por los proveedores de servicios (ej. AWS Cost Explorer, Google Cloud Billing Reports). Configurar alertas para umbrales de gasto. OpenClaw, al ser una plataforma integradora, puede consolidar métricas de uso y costos si se le dota de los conectores adecuados a los sistemas de facturación de cada proveedor.
- Optimización de Llamadas: Reducir la frecuencia de llamadas a APIs externas. Si la información es estática o cambia poco, implementar mecanismos de caché. Por ejemplo, si una skill consulta un tipo de cambio, no es necesario hacerlo en cada ejecución si el valor se actualiza solo una vez al día.
- Gestión de Cuotas: Establecer cuotas de uso a nivel de proyecto o skill. Muchos proveedores permiten configurar límites máximos de gasto mensual o diario. Aunque esto no reduce el costo unitario, previene gastos excesivos.
- Selección de Modelos: Elegir el modelo de IA adecuado para la tarea. Modelos más grandes y capaces suelen ser más caros. Para tareas sencillas, un modelo más pequeño y económico puede ser suficiente.
- Procesamiento por Lotes (Batch Processing): Si es posible, agrupar múltiples solicitudes en una sola llamada a la API. Esto puede reducir el costo unitario en algunos servicios y optimizar el rendimiento al disminuir la sobrecarga de conexiones.
Evaluar el costo marginal de una llamada adicional a la API frente al valor que aporta. Si una llamada no es estrictamente necesaria para el objetivo de la skill, debe eliminarse.
Gestión de Rate Limits
Los rate limits son restricciones impuestas por los proveedores de APIs para limitar el número de solicitudes que un cliente puede hacer en un período de tiempo determinado (ej. 100 solicitudes por minuto). Exceder estos límites resulta en errores (comúnmente HTTP 429 Too Many Requests) y puede llevar a la suspensión temporal o permanente del acceso a la API.
La gestión de rate limits es crítica para la estabilidad de las skills. Ignorar estos límites puede detener la operación de una skill o, en el peor de los casos, afectar a múltiples servicios dependientes.
- Implementación de Retries con Backoff Exponencial: Cuando se recibe un error de rate limit, la skill no debe reintentar la llamada inmediatamente. Debe esperar un tiempo creciente antes de cada reintento. Esto se conoce como exponential backoff. Muchos SDKs de APIs externas ya incluyen esta lógica.
- Control de Concurrencia: Limitar el número de llamadas simultáneas a una API. Si OpenClaw ejecuta múltiples instancias de una skill, todas pueden intentar llamar a la misma API al mismo tiempo, excediendo el límite. Implementar un mecanismo de cola o semáforo puede ayudar.
- Tokens de Uso: Algunos proveedores utilizan un sistema de tokens o créditos que se recargan con el tiempo. La skill debe consultar el estado de estos tokens antes de realizar llamadas críticas.
Configuración de Rate Limits en OpenClaw
OpenClaw no impone rate limits intrínsecos sobre las llamadas a APIs externas, pero permite la implementación de lógica para respetarlos. Esto se realiza a nivel de la skill o del conector.
# Ejemplo conceptual de implementación de rate limit dentro de una skill
import time

LAST_API_CALL_TIME = 0
RATE_LIMIT_SECONDS = 0.5 # 2 llamadas por segundo

def call_external_api(payload):
    global LAST_API_CALL_TIME
    current_time = time.time()
    time_since_last_call = current_time - LAST_API_CALL_TIME

    if time_since_last_call < RATE_LIMIT_SECONDS:
        sleep_time = RATE_LIMIT_SECONDS - time_since_last_call
        time.sleep(sleep_time)
        print(f"Esperando {sleep_time:.2f} segundos para respetar rate limit.")

    # Aquí iría la lógica real de la llamada a la API externa
    print(f"Realizando llamada a API con payload: {payload}")
    LAST_API_CALL_TIME = time.time()
    return {"status": "success"}

# Simulación de uso
for i in range(5):
    call_external_api(f"data_{i}")
    time.sleep(0.1) # Simula trabajo entre llamadas
Este ejemplo muestra una implementación básica de throttling. Para escenarios más complejos, se recomienda utilizar librerías de terceros o frameworks que manejen colas y reintentos de forma robusta. La clave es que la lógica de la skill sea consciente de los límites del proveedor y actúe en consecuencia.
Subagentes y Delegación con Conciencia de Costos
Cuando se utilizan subagentes o se delegan tareas a otros componentes, la complejidad del control de costos y rate limits aumenta. Cada subagente o componente delegado puede generar sus propias llamadas a APIs externas.
- Cuotas por Subagente: Asignar cuotas específicas a cada subagente o flujo de trabajo para evitar que uno solo consuma todo el presupuesto o exceda los límites de la API.
- Auditoría de Uso: Implementar un sistema de auditoría que registre las llamadas a APIs externas realizadas por cada componente. Esto permite identificar qué partes del sistema están generando más costos o hits de rate limit.
- Diseño Jerárquico: Diseñar los flujos de trabajo de manera que las llamadas costosas o sensibles a rate limits se centralicen o se realicen de forma controlada por un componente maestro que gestione los límites.
Aplicación Práctica: Qué Hacer el Lunes
- Identificar APIs Críticas: Revisar las skills existentes o en desarrollo que interactúan con APIs externas o servicios de IA. Identificar cuáles son las más costosas o las que tienen los rate limits más estrictos.
- Consultar Documentación: Para cada API crítica, consultar la documentación del proveedor para entender sus modelos de facturación y límites de tasa. Anotar estos detalles.
- Implementar Monitoreo Básico: Configurar alertas de gasto en las plataformas de los proveedores de servicios (ej. Azure, GCP, AWS) para las APIs identificadas. Si OpenClaw tiene acceso a métricas de uso, integrar estas alertas.
- Refactorizar Skills (si aplica): Si una skill realiza llamadas redundantes o no optimizadas, planificar una refactorización para implementar caché, procesamiento por lotes o lógica de throttling básica. Priorizar las skills de alto volumen o alto costo.
There are no comments for now.
to be the first to leave a comment.