Paginación en APIs: Procesamiento de grandes volúmenes de datos
La paginación es un mecanismo esencial para interactuar con APIs que limitan la cantidad de datos retornados por cada solicitud. Esta lección cubre cómo diseñar workflows en n8n para procesar grandes volúmenes de datos de forma iterativa, asegurando la recuperación completa de la información.
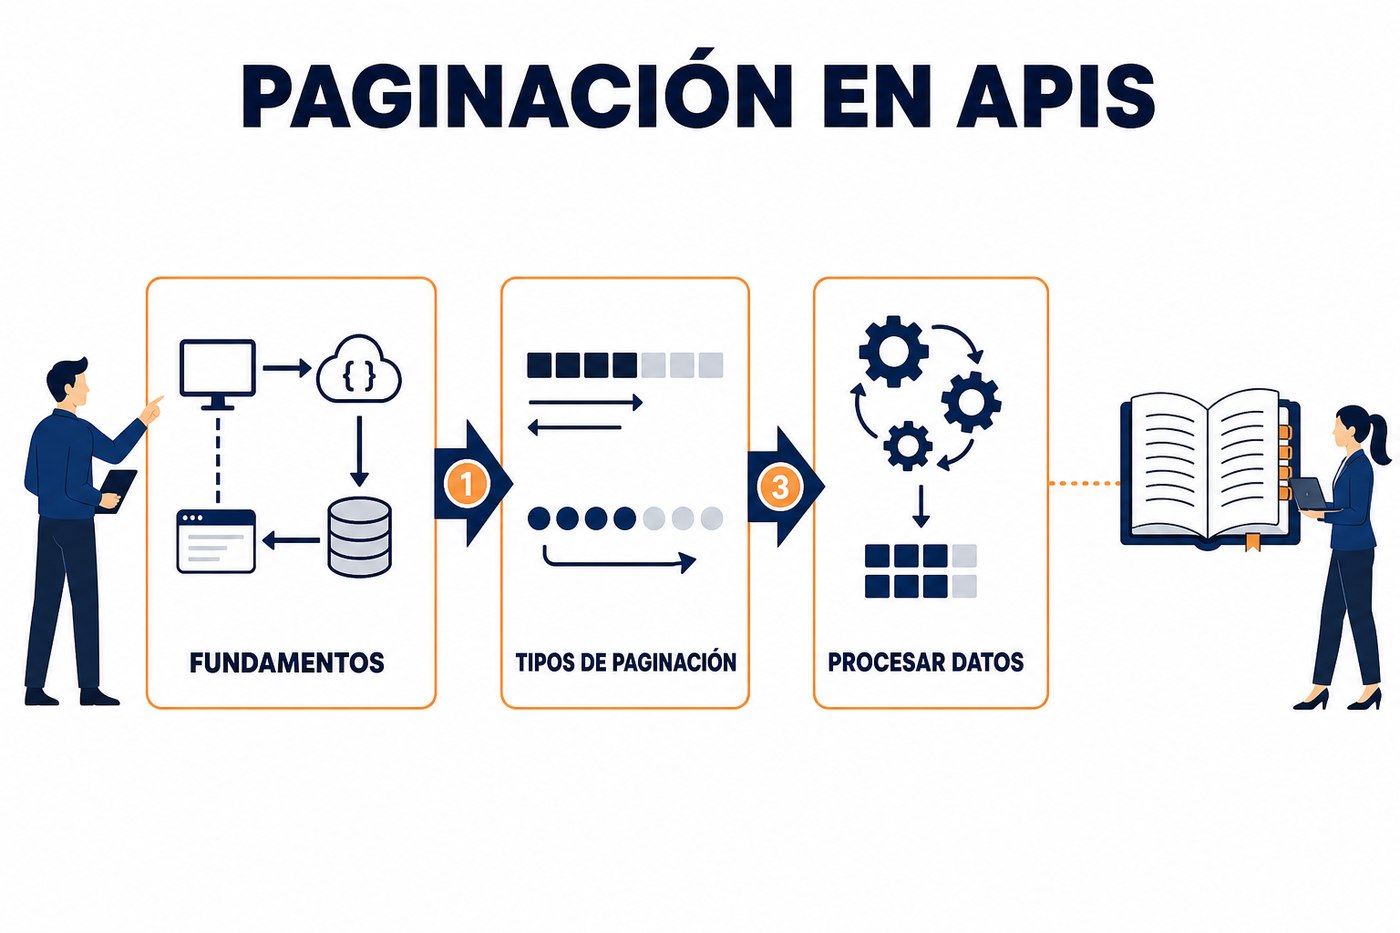
Fundamentos de la paginación en APIs
Las APIs implementan paginación para optimizar el rendimiento y evitar el consumo excesivo de recursos. Al limitar el tamaño de las respuestas, se reduce la carga en el servidor y el cliente. Ignorar la paginación lleva a la pérdida de datos y a la imposibilidad de procesar conjuntos de información extensos. Es fundamental identificar el tipo de paginación que utiliza una API para configurar correctamente el workflow.
Los mecanismos de paginación más comunes son:
- Offset/Limit (o Page/Size): Se especifica un número de página (o un índice de inicio, offset) y la cantidad de registros por página (limit o size). El cliente calcula el offset para la siguiente página. Es el método más intuitivo, pero puede ser ineficiente con grandes conjuntos de datos si el offset es muy grande, ya que el servidor aún debe procesar los registros anteriores.
- Cursor-based (o Token-based): La API devuelve un "cursor" (un token o ID) que indica el punto de inicio para la siguiente solicitud. Este cursor suele ser opaco para el cliente. Es más eficiente para grandes volúmenes porque el servidor no necesita recalcular el offset, solo busca desde el cursor proporcionado. Es el método preferido para APIs modernas.
- Time-based: Se utilizan marcas de tiempo para filtrar los datos, generalmente solicitando registros "desde" y "hasta" una fecha/hora específica. Requiere que los datos estén ordenados por fecha y que la API soporte este tipo de filtrado.
Paginación Offset/Limit en n8n
Para implementar paginación offset/limit en n8n, se utiliza un bucle que incrementa el offset o el número de página en cada iteración hasta que la API no retorne más datos. Los nodos HTTP Request son clave aquí.
- Inicialización: Se inicia el workflow con un nodo que define las variables iniciales, como
page=1ylimit=100(ooffset=0). Un nodo Set o un Start node pueden cumplir esta función. - Solicitud HTTP: Un nodo HTTP Request realiza la llamada a la API, enviando los parámetros
pageylimit(ooffset). Estos parámetros suelen ir en la URL o en los query parameters. - Evaluación de la respuesta: Después de la solicitud, se evalúa la respuesta. Si la API retorna un arreglo vacío de datos, o si el número de elementos retornados es menor que el
limit, significa que se ha alcanzado el final de los datos. Un nodo IF puede verificar esta condición. - Incremento del offset/página: Si hay más datos, se incrementa el
pageo eloffsetpara la siguiente iteración. Un nodo Set puede actualizar estas variables. Por ejemplo,offset = offset + limit. - Bucle: Se utiliza un nodo Loop para repetir el proceso. El Loop se conecta al nodo HTTP Request, creando un ciclo que se repite hasta que la condición de fin de paginación se cumpla.
Siempre verifica la documentación de la API para los nombres exactos de los parámetros de paginación (ej. page vs. p, limit vs. pageSize) y el valor máximo permitido para el límite. Superar el límite puede generar errores o ser ignorado por la API.
// Ejemplo de expresión para calcular el siguiente offset
// Asumiendo que 'offset' y 'limit' son variables globales o de ejecución
{{ $json.offset + $json.limit }}
Paginación Cursor-based en n8n
La paginación basada en cursor es más robusta. En lugar de un índice numérico, la API devuelve un "cursor" que se usa en la siguiente solicitud. Este cursor puede ser un next_token, next_cursor, o un ID de registro.
- Inicialización: Se inicia el workflow sin un cursor, o con un valor inicial si la API lo requiere (ej.
nullo una cadena vacía). - Solicitud HTTP: El nodo HTTP Request envía el cursor actual (si existe) como parámetro de query, header o parte del cuerpo de la solicitud, según la API.
- Evaluación de la respuesta: La API retornará un nuevo cursor en su respuesta (ej.
response.data.next_cursor). Si no hay un nuevo cursor, o si el cursor esnull/vacío, significa que se ha alcanzado el final de los datos. Un nodo IF puede verificar la existencia o valor del nuevo cursor. - Actualización del cursor: Si se recibe un nuevo cursor, se actualiza la variable del cursor para la siguiente iteración. Un nodo Set es útil aquí.
- Bucle: Similar al método offset/limit, se usa un nodo Loop para repetir el proceso hasta que no haya un nuevo cursor.
La ventaja principal es que no hay riesgo de saltarse datos si los elementos se añaden o eliminan durante el proceso de paginación, ya que el cursor apunta directamente al siguiente conjunto de datos.
Agregación y procesamiento de datos paginados
A medida que se recuperan los datos de cada página, es necesario consolidarlos para su procesamiento posterior. El nodo Item Lists o un Merge node en modo 'Merge by Index' son opciones para combinar los resultados de múltiples iteraciones.
- Acumulación con Item Lists: El nodo Item Lists, configurado para 'Append', puede acumular los ítems de cada respuesta de la API en una lista única. Esto es útil si se necesita un arreglo consolidado de todos los registros.
- Procesamiento por lote: Para volúmenes de datos extremadamente grandes que no caben en la memoria de un solo nodo, se puede procesar cada página de datos inmediatamente después de recuperarla, en lugar de acumularla toda. Esto reduce el consumo de memoria del workflow.
- Manejo de errores: Durante la paginación, pueden ocurrir errores (ej. límites de tasa, errores de red). Es crucial implementar el manejo de errores por nodo y reintentos para asegurar que el proceso se complete. Un "Error Workflow" puede capturar y registrar estos incidentes.
Consideraciones de eficiencia y límites de tasa
Al procesar grandes volúmenes de datos, es vital considerar los límites de tasa (rate limits) de la API. Hacer demasiadas solicitudes en poco tiempo puede resultar en bloqueos temporales o permanentes.
- Retrasos (Delays): Utiliza el nodo Wait o el parámetro 'Delay' en el nodo HTTP Request para introducir pausas entre las solicitudes. Esto ayuda a cumplir con los límites de tasa. La duración del retraso debe basarse en la documentación de la API.
- Concurrencia: n8n permite ejecutar múltiples ramas de un workflow en paralelo. Sin embargo, para paginación secuencial, la concurrencia puede agravar los problemas de límites de tasa. Es preferible mantener la paginación en un flujo secuencial.
- Manejo de errores 429 (Too Many Requests): Si la API devuelve un código de estado 429, el workflow debe pausar y reintentar la solicitud después de un tiempo. Muchos nodos HTTP Request tienen opciones de reintento automático que pueden configurarse para manejar esto.
Aplicación práctica: Procesamiento de registros de clientes
El lunes, diseña un workflow para integrar los registros de clientes de un sistema CRM externo que expone una API paginada. Supongamos que la API usa paginación offset/limit con un limit máximo de 500 y un offset que empieza en 0. La API devuelve un arreglo de objetos de cliente en la clave data de la respuesta.
- Crea un nodo Start que inicialice un
offseten 0 y unlimiten 500. - Configura un nodo HTTP Request para llamar a la API del CRM, pasando
offsetylimitcomo query parameters. - Añade un nodo IF que verifique si
response.dataestá vacío o si su longitud es menor que ellimit. Si es así, significa el fin de la paginación. - Si hay datos, utiliza un nodo Set para actualizar el
offset:offset = offset + limit. - Conecta el nodo Set de vuelta al nodo HTTP Request con un nodo Loop para crear el ciclo de paginación.
- Después del nodo HTTP Request (y antes del IF), inserta un nodo Item Lists en modo 'Append' para acumular todos los registros de clientes. El resultado final del workflow será un único arreglo con todos los clientes recuperados.
No hay comentarios por ahora.
para ser el primero en comentar.