Ollama: servir modelos locales
Ollama es el runtime más simple para servir modelos de lenguaje en local. Descarga, ejecuta y expone una API compatible con OpenAI.
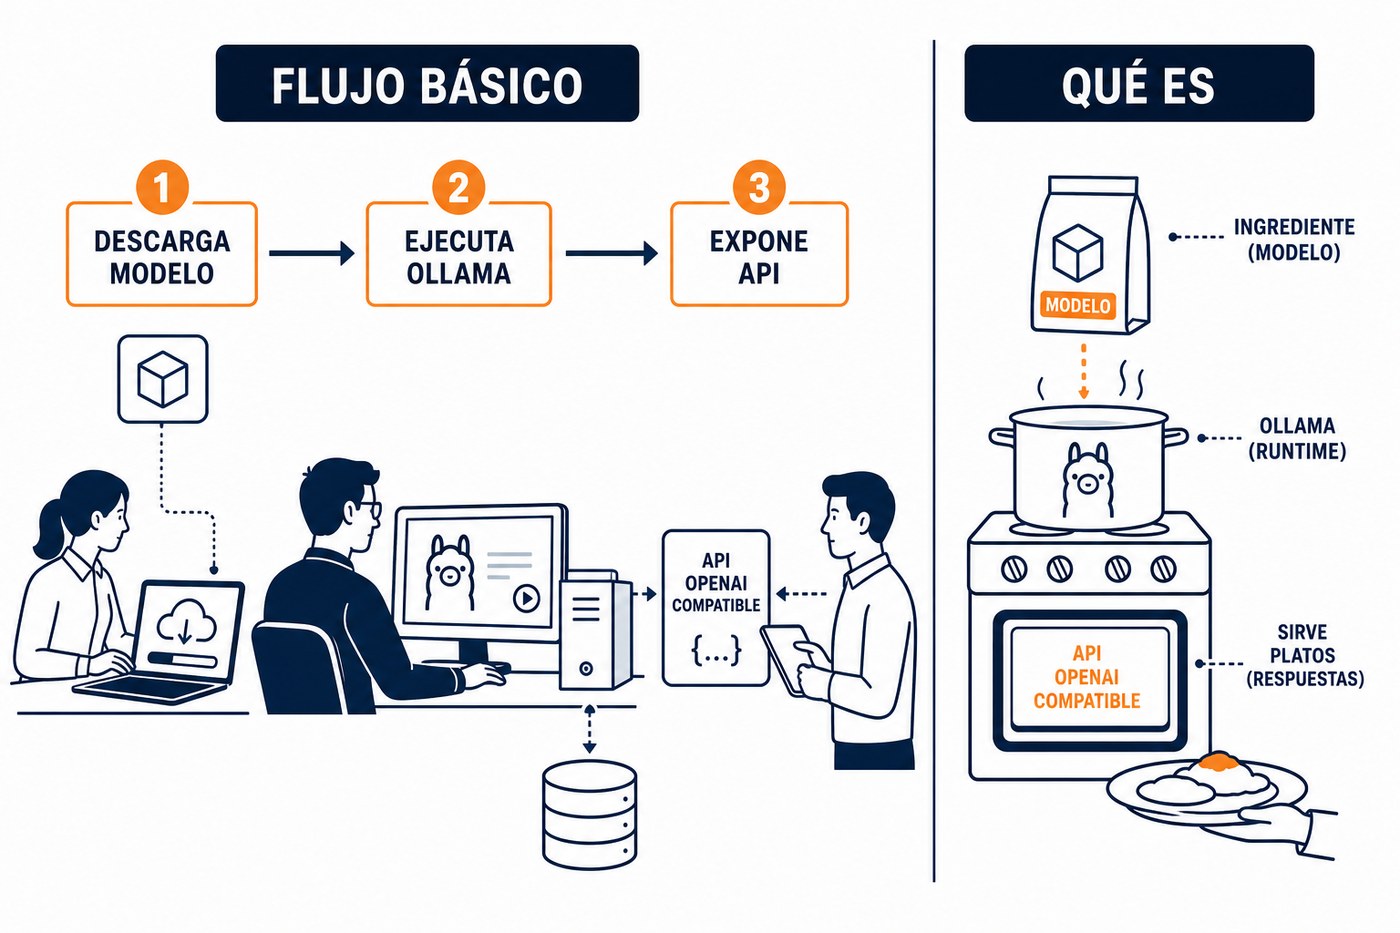
Flujo básico
ollama serve                 # arranca el servidor (puerto 11434)
ollama pull qwen3:32b        # descarga un modelo
ollama run qwen3:32b         # chatea en consola
curl localhost:11434/api/tags  # lista modelos
Por qué es clave
- Local: los datos no salen de la infraestructura.
- API OpenAI-compatible: tus apps se conectan sin cambiar código.
- Modelos: LLM, embeddings y visión en el mismo runtime.
EN INT
LicitIA genera sus informes con qwen3:32b local y embeddings bge-m3. Costo de inferencia = electricidad, no tokens en la nube.
Calificación
No hay comentarios por ahora.
para ser el primero en comentar.