Generación de Voz (TTS) en OpenClaw
La integración de capacidades de Text-to-Speech (TTS) en OpenClaw permite que las Skills generen respuestas de voz, ampliando la interacción a interfaces auditivas. Esta lección detalla cómo implementar TTS, seleccionar proveedores y configurar las características de la voz para distintos escenarios operativos.
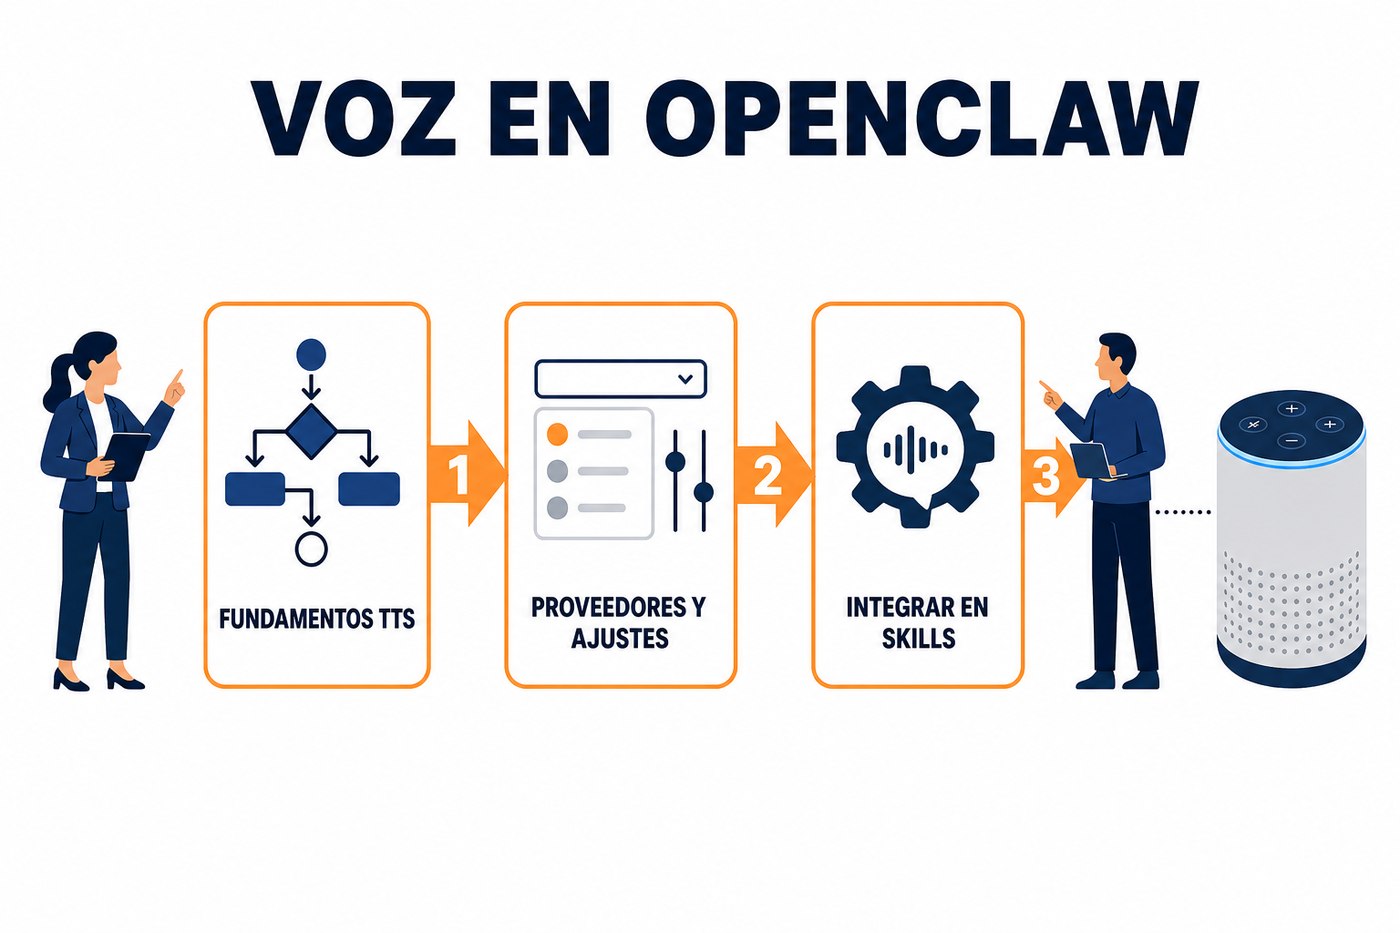
Fundamentos de la Generación de Voz en OpenClaw
OpenClaw no incluye un motor TTS nativo. En su lugar, se integra con servicios externos de TTS. Esto permite aprovechar la evolución constante de la calidad de voz y el soporte multilingüe de proveedores especializados. La elección del proveedor depende de factores como la calidad de voz requerida, los idiomas soportados, los costos y las políticas de uso.
La integración se realiza a través de las APIs de estos servicios. La Skill de OpenClaw envía texto al servicio TTS, que devuelve un archivo de audio (generalmente MP3, WAV u OGG). Este archivo se reproduce en el canal de salida configurado, como una llamada telefónica, un sistema de megafonía o una aplicación de mensajería con soporte de audio.
Selección de Proveedores y Configuración
Existen múltiples proveedores de TTS. Los más comunes en entornos empresariales por su robustez y calidad son:
- Google Cloud Text-to-Speech: Ofrece voces estándar, WaveNet y voces personalizadas. Amplio soporte de idiomas y dialectos. Permite ajustar velocidad, tono y volumen.
- Amazon Polly: Voces estándar y neuronales (NTTS). Soporte para Speech Synthesis Markup Language (SSML) para control detallado de la pronunciación, pausas y entonación.
- Microsoft Azure Text-to-Speech: Voces estándar y neuronales. Ofrece una gran variedad de estilos de voz (ej. alegre, triste, de noticiero) y la capacidad de crear voces personalizadas a partir de grabaciones.
- IBM Watson Text to Speech: Voces estándar y expresivas. Soporte para SSML y personalización de voces.
La configuración en OpenClaw implica establecer las credenciales de API del proveedor seleccionado y especificar los parámetros de voz deseados. Esto generalmente se hace en el archivo de configuración de la Skill o a través de variables de entorno para mantener la seguridad de las claves.
# Ejemplo conceptual de configuración en un archivo .env o config.py
# NO USAR VALORES REALES EN CÓDIGO FUENTE
TTS_PROVIDER = "GOOGLE_CLOUD"
GOOGLE_CLOUD_API_KEY = "tu_clave_api_de_google"
DEFAULT_VOICE_LANG = "es-MX"
DEFAULT_VOICE_NAME = "es-MX-Wavenet-D"
DEFAULT_VOICE_GENDER = "FEMALE"
DEFAULT_VOICE_SPEED = 1.0 # 1.0 es velocidad normal
DEFAULT_VOICE_PITCH = 0.0 # 0.0 es tono normalNunca incrustes claves de API directamente en el código fuente. Utiliza variables de entorno o un sistema de gestión de secretos para proteger las credenciales. Esto es crítico para la seguridad operativa y el cumplimiento de políticas de acceso.
Control de Voz y SSML
Para un control más granular sobre la salida de voz, la mayoría de los proveedores de TTS soportan Speech Synthesis Markup Language (SSML). SSML es un lenguaje de marcado basado en XML que permite a los desarrolladores especificar cómo se debe pronunciar el texto. Con SSML, se pueden controlar aspectos como:
- Pausas: Insertar silencios de duración específica.
- Énfasis: Resaltar palabras o frases.
- Pronunciación: Especificar la pronunciación fonética de palabras complejas o acrónimos.
- Tono y Velocidad: Ajustar dinámicamente el tono y la velocidad del habla en segmentos específicos.
- Volumen: Controlar el volumen de partes del discurso.
- Cambio de Voz: Cambiar la voz (ej. de hombre a mujer) dentro de la misma locución (dependiendo del proveedor).
El uso de SSML es fundamental para crear experiencias de voz naturales y comprensibles, especialmente en aplicaciones donde la claridad y la entonación son críticas, como sistemas de atención al cliente o notificaciones de emergencia.
<speak>
  Hola. <break time="500ms"/> Soy su asistente virtual.
  <prosody rate="slow" pitch="x-low">Por favor, escuche atentamente.</prosody>
  La palabra <phoneme alphabet="ipa" ph="pɪt͡sa">pizza</phoneme> se pronuncia así.
</speak>
Integración en Skills de OpenClaw
Dentro de una Skill de OpenClaw, la generación de voz se invoca cuando se necesita una respuesta auditiva. El flujo general es el siguiente:
- La Skill procesa la entrada del usuario y determina la respuesta textual.
- La Skill envía el texto (posiblemente con SSML) al servicio TTS configurado.
- El servicio TTS genera un archivo de audio y lo devuelve a la Skill.
- La Skill recibe el archivo de audio y lo entrega al conector de canal (ej. conector de telefonía, conector de WhatsApp) para su reproducción al usuario.
- El conector de canal reproduce el audio.
Es crucial manejar los errores y los tiempos de espera (timeouts) en la comunicación con el servicio TTS. Si el servicio no responde, la Skill debe tener una estrategia de fallback, como enviar una respuesta de texto o indicar un problema técnico.
Consideraciones de Costo y Rendimiento
Los servicios de TTS suelen cobrar por el volumen de caracteres procesados. Las voces neuronales o de mayor calidad suelen tener un costo por carácter más elevado que las voces estándar. Es vital monitorear el uso para controlar los costos operativos. Algunos proveedores ofrecen un nivel gratuito limitado que puede ser útil para pruebas o aplicaciones de bajo volumen.
El rendimiento también es un factor. La latencia en la generación de voz puede impactar la experiencia del usuario. Elegir un proveedor con baja latencia y optimizar las solicitudes (ej. no enviar textos excesivamente largos en una sola solicitud si no es necesario) puede mejorar la fluidez de la interacción.
Aplicación Práctica: Implementación de TTS para Confirmaciones
Para el lunes, identifique una Skill existente en OpenClaw que maneje confirmaciones o notificaciones críticas. Modifique esta Skill para que, además de la respuesta textual, genere una respuesta de voz utilizando un servicio TTS. Siga estos pasos:
- Seleccione un proveedor TTS: Si no hay uno predefinido, elija Google Cloud Text-to-Speech o Amazon Polly para esta prueba, configurando las credenciales de API de forma segura (ej. en variables de entorno).
- Defina la voz y el idioma: Seleccione una voz en español de México (es-MX) que sea clara y profesional. Defina el nombre de la voz (ej. 'es-MX-Wavenet-D') y el género.
- Integre la llamada a la API TTS: Dentro del código de la Skill, después de generar el texto de confirmación (ej. 'Su solicitud ha sido recibida con el folio XXXXX.'), realice una llamada a la API del servicio TTS para convertir este texto en audio.
- Maneje el archivo de audio: Reciba el archivo de audio (ej. MP3) y prepárelo para el conector de canal. Si está trabajando con un conector de telefonía o un canal que soporta audio, asegúrese de que el archivo se envíe correctamente para su reproducción.
- Pruebe la Skill: Ejecute la Skill y verifique que la confirmación se emita tanto en texto como en voz, y que la calidad de la voz sea aceptable. Evalúe la latencia percibida.
Esta práctica le permitirá comprender el ciclo de vida completo de la generación de voz en OpenClaw y los puntos clave de configuración y control.
No hay comentarios por ahora.
para ser el primero en comentar.