Optimización del Rendimiento y Costos
Optimización del Rendimiento y Costos
Optimizar grafos en LangGraph reduce consumo de recursos y latencia, y controla el gasto en LLMs. La clave está en llamadas selectivas, grafos compactos, memoria bien gestionada y monitoreo constante.
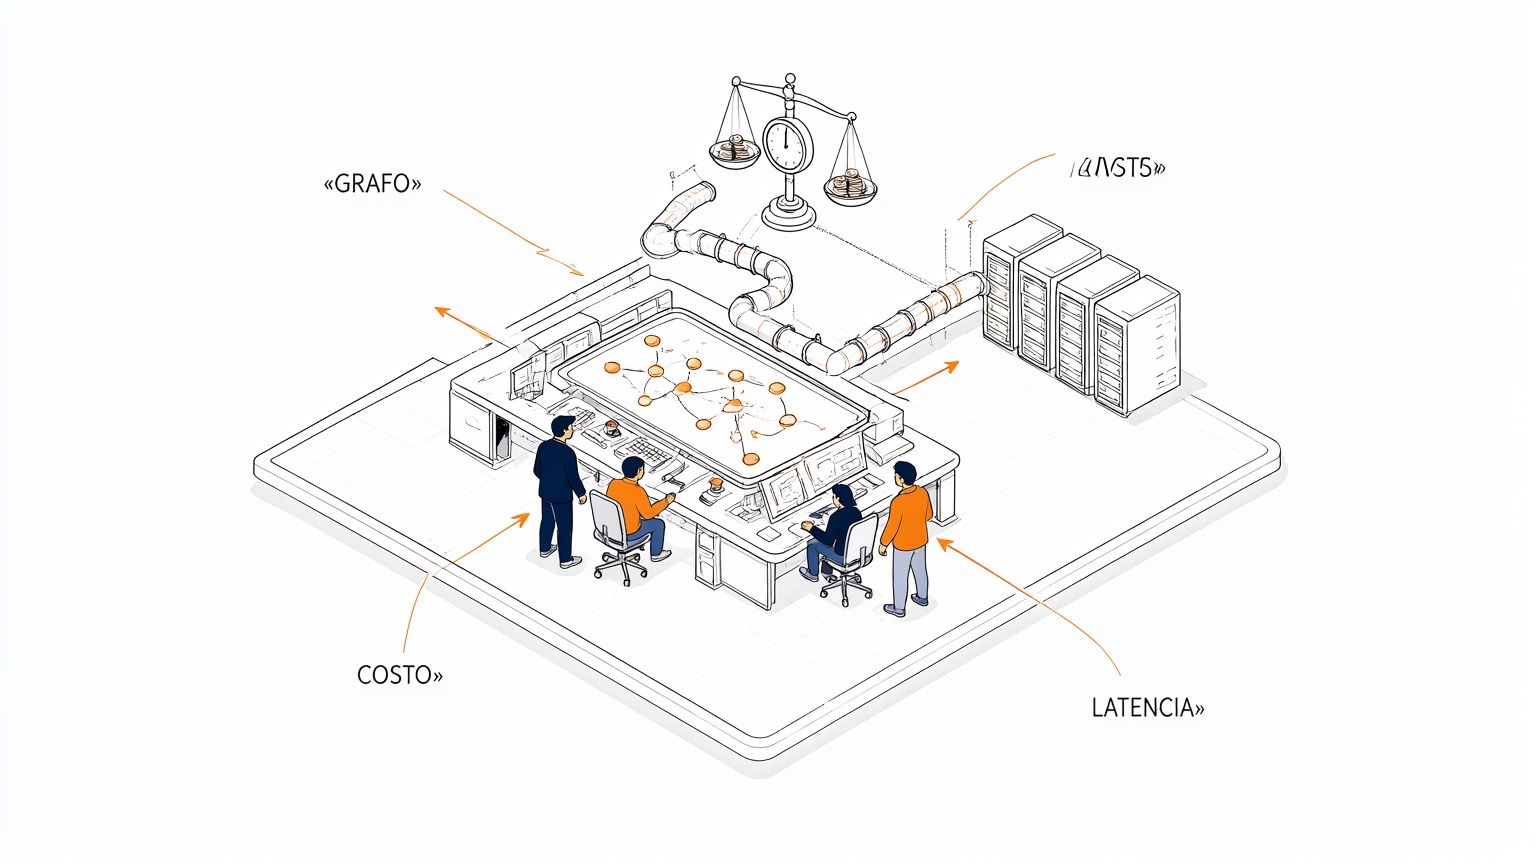
Llamadas salientes controladas
Cada llamada a un LLM cuesta tokens y tiempo. Conviene limitar las invocaciones a lo indispensable, usar modelos pequeños para tareas simples y cachear respuestas repetidas. Así el grafo deja de gastar recursos en operaciones que no aportan valor.

Grafos compactos y eficientes
Un grafo con nodos y aristas innecesarios multiplica la latencia. Recorta pasos redundantes, combina nodos que hacen trabajo similar y usa enrutamiento condicional para evitar rutas largas. Un diseño compacto se ejecuta más rápido y consume menos.
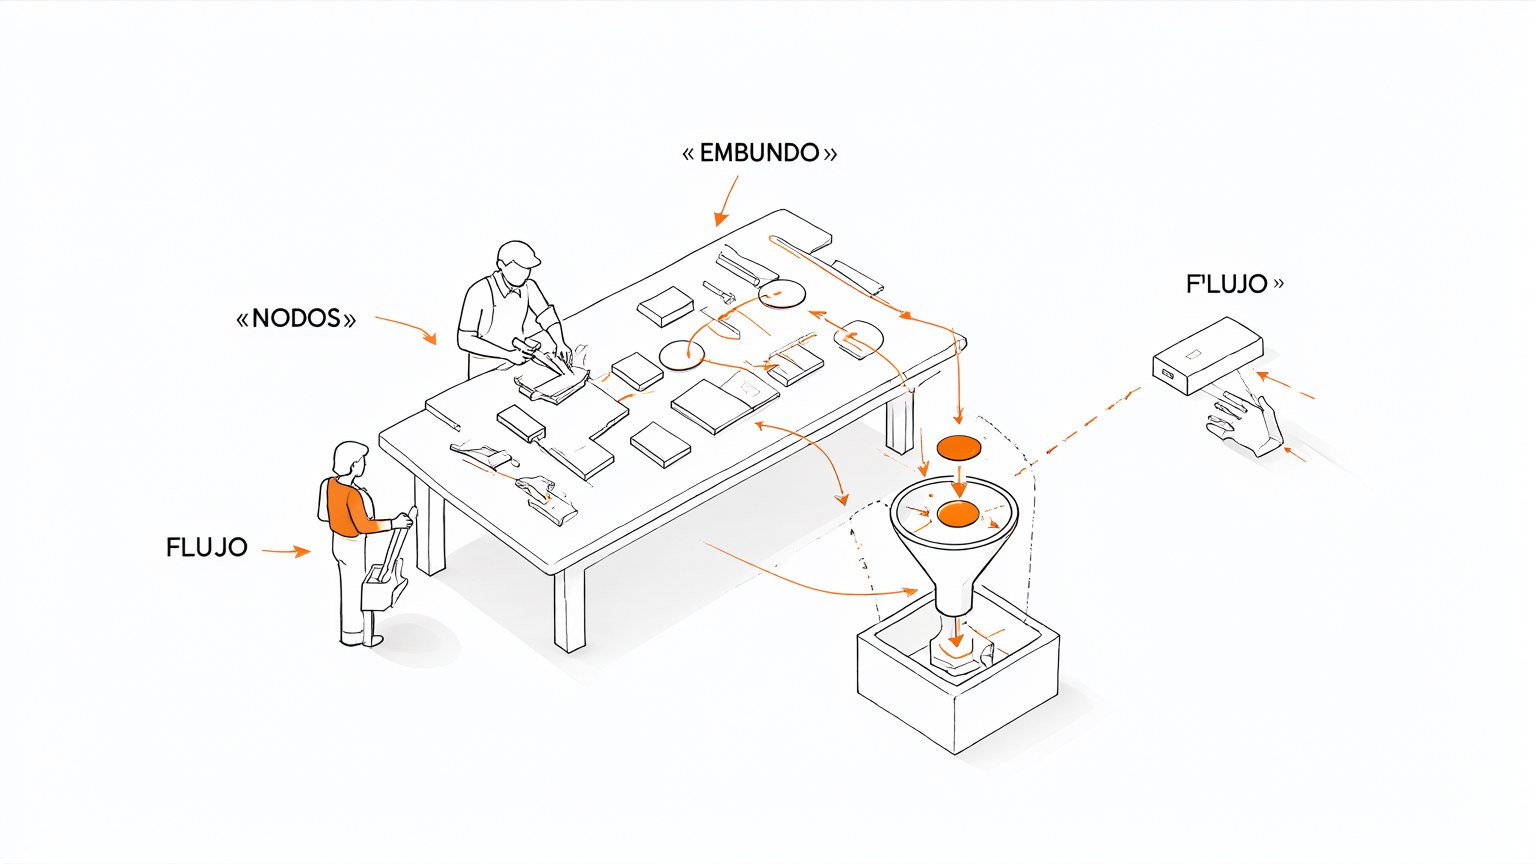
Memoria con orden
La memoria persistente mejora la experiencia, pero también crece y encarece cada paso. Define qué guardar, cuándo expirar y cómo recuperar solo lo relevante. Una bodega de memoria organizada evita arrastrar contexto inútil en cada llamada.

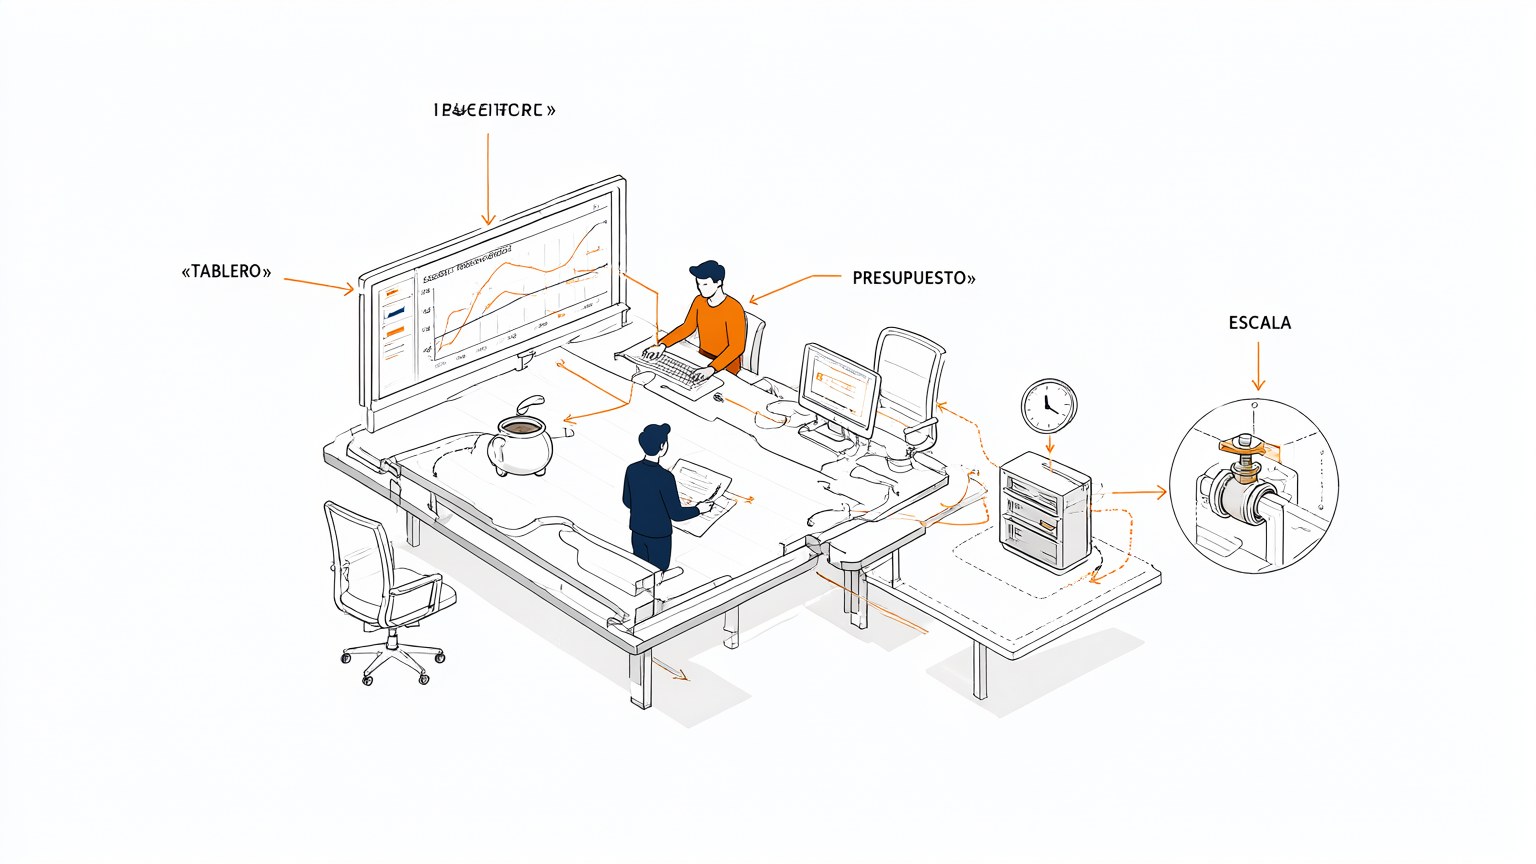
Tablero de gasto y velocidad
Sin medición no hay optimización real. Monitorea tokens consumidos, latencia por nodo y costo por ejecución para detectar cuellos de botella. Los tableros revelan dónde ajustar antes de que el gasto se salga de control.
There are no comments for now.
to be the first to leave a comment.